1.1 定义
目前关于大模型(Large Models)并没有统一的定义,通常是指训练数据庞大、参数规模巨大、能力强大的深度神经网络模型。
通常,大模型的参数量通常在10亿以上,目前顶尖模型的参数规模已达万亿级别。
1.2 为什么会出现大模型?
大模型的出现并非偶然,而是数据、算力与模型架构协同演进的结果。
1)数据够多:训练范式的改变使得训练数据规模获得了数量级上的跃迁
传统监督学习高度依赖
人工标注数据(对原始数据进行标记、分类、注释或结构化的过程,便于机器可识别和理解),获取成本高、规模受限。比如,分类标注:为整张图像分配类别标签(如"猫"、"狗",人工标注的)
命名实体识别:标注文本中的人名、地名、组织名等实体
情感分析:标注文本的情感倾向(正面、负面、中性)
语音转写:将语音内容转换为文本
大模型主要采用
自监督学习范式(如“预测下一个token”),能够直接利用海量的未标注文本与多模态数据进行模型的训练,可用数据规模获得了数量级上的跃迁。自监督学习,本质上属于无监督学习的一种特殊形式,但采用了监督学习的训练方式。核心思想是利用数据本身的内在结构或属性,
自动为无标签数据生成伪标签,然后像监督学习一样训练模型,无需依赖人工标注。比如,掩码语言建模。如Qwen3的预训练阶段使用了约
36T个token(近似理解为词)的语料,这一数据规模远超传统机器学习时代的训练数据总量。
大规模矩阵运算,这类计算具有高度并行性,与GPU/TPU的硬件架构天然契合。
随着硬件性能的不断提升,单卡算力不断突破,目前英伟达最新一代的B200在FP16(半精度浮点数)条件下的峰值算力已达5PFLOPS(每秒约$5*10^{15}$次浮点运算,$$1P=10^{3}T=10^{6}G=10^{9}M=10^{12}K=10^{15}$$)。
与此同时,数据并行、张量并行、流水线并行等分布式训练体系日趋成熟,使得跨节点、跨集群训练超大规模参数模型成为可能。
数据并行:每个设备持有完整的模型副本,不同设备处理不同的数据子集,通过梯度聚合同步更新模型参数。
张量并行:将模型中的张量(如权重矩阵)按维度切分到不同设备上,每个设备只处理部分张量,通过集合通信合并结果。
流水线并行:将模型按层或模块切分成多个阶段,每个阶段分配到不同设备,数据按流水线方式依次传递。
3)架构合理:Transformer架构的出现
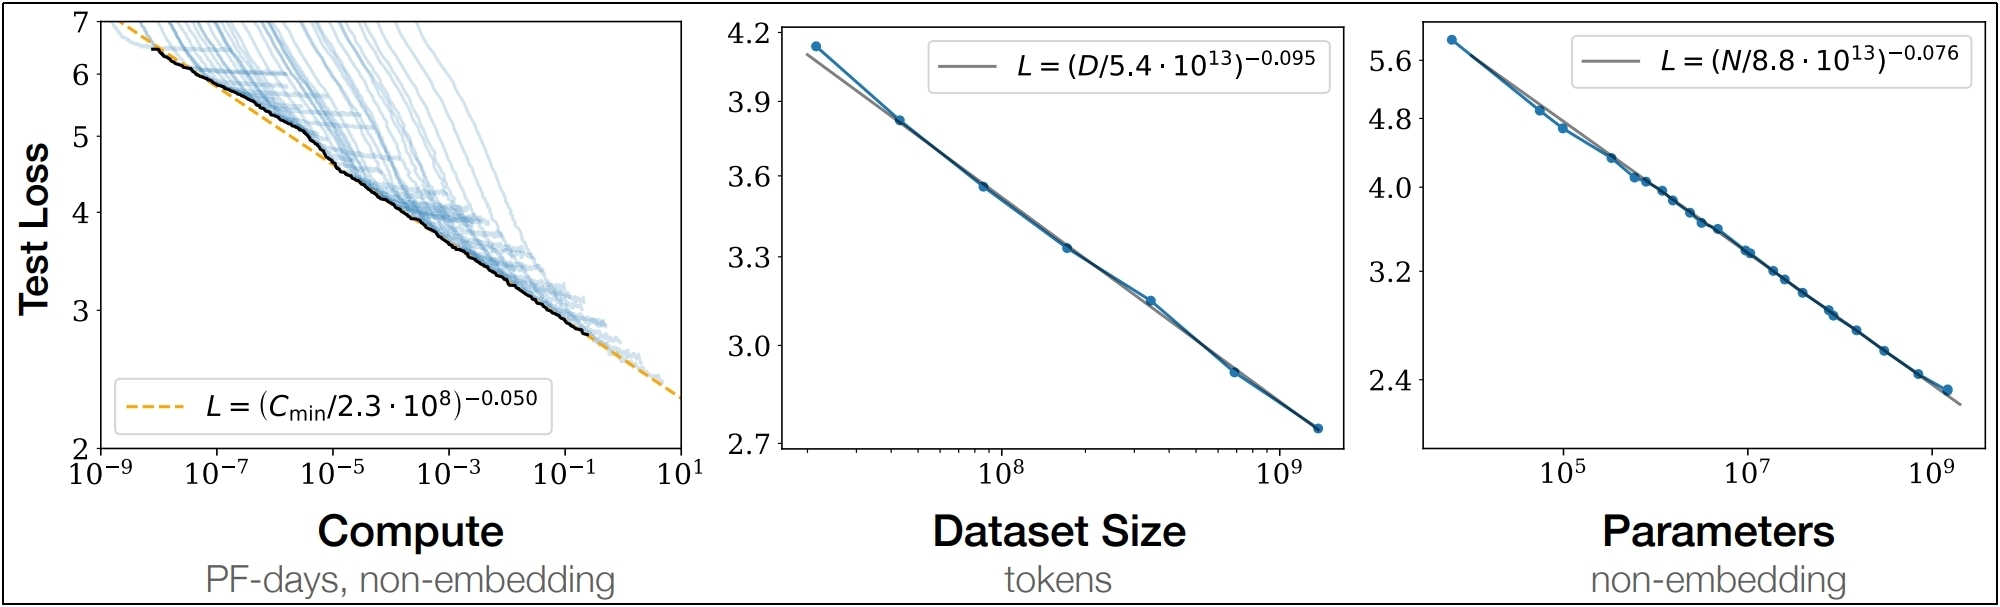
Transformer架构支持并行计算,并且在模型规模、数据规模、训练步数(算力开销)提升时展现出稳定的性能收益(即良好的“可扩展性”,如下图所示,图中的Test Loss表示损失函数的值,用于衡量模型性能)。
损失函数(Loss Function)是用于量化模型预测值与真实值之间差异的数学函数,也称为代价函数或目标函数。它通过计算预测错误程度来评估模型性能,值越小表示预测越准确,值越大表示预测误差越大。比如,均方误差(MSE)、平均绝对误差(MAE)等。
4)总结
综上,数据规模的跃迁、算力基础设施的发展,和Transformer架构优异的可扩展性,共同推动了模型规模和性能的持续膨胀,迎来了“大模型时代”。
1.3 大模型计量单位
在大语言模型(LLM)及更一般的大模型研究中,通常从参数规模、训练数据集规模和计算规模三个维度来度量模型的规模。
1)参数规模(Parameters Scale)
参数是指深度神经网络里面“神经元数量、层数、神经元权重、神经元偏移量、超参数”等数据的集合。
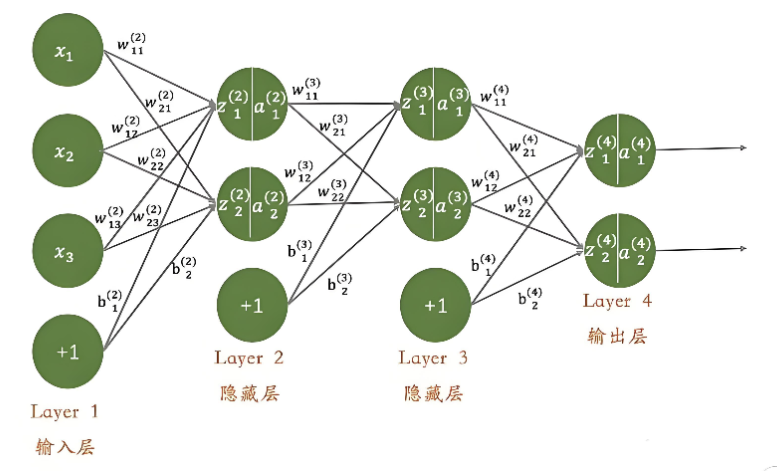
大模型参数规模通常以B为单位,B是Billion的缩写,即10亿,$$10^{9}$$。
如:7B模型的参数量为70亿。
2)训练数据集规模
LLM的训练是在文本语料上进行的,语料处理的第一步是分词为一系列token,所以通常用token的数量衡量LLM训练数据集规模。
1B token = $$10^{9}$$token = 10亿token
1T token = $$10^{3}$$B token = $$10^{12}$$token = 1万亿token
多模态模型的数据集格式五花八门,无法用统一单位度量,此处不讨论。
说明:token是什么
可能是一个英文单词,也可能是半个,三分之一个
可能是一个中文词,或者一个汉字
token是计算机理解人类语言的基础单位。大模型在开训前,需要先训练一个tokenizer模型。它能把所有的文本,切成token。
1个英文字符≈0.3个token。1个中文字符≈0.6个token。
3)计算规模
计算规模是指大模型训练消耗的计算量。
大模型是一系列浮点数的组合,训练过程涉及大量浮点数运算,因此计算规模通常用FLOPs(Floating Point Operations,浮点运算次数)来衡量。
1FLOPs=1次浮点运算
1PFLOPs=$$10^{15}$$FLOPs
1EFLOPs=$$10^{3}$$PFLOPs=$$10^{18}$$FLOPs
1.4 大模型分类
| 分类标准 | 类别 | 示例 |
|---|---|---|
| 按照模态分类 | 大语言模型 | Qwen3/DeepSeek-V3/GPT-5语言模块 |
| 多模态理解模型 | Qwen3-VL/GPT-5/Gemini-3 | |
| 多模态生成模型 | Stable Diffusion/DALL·E/Nano-Banana | |
| 按照功能分类 | 生成式大模型 | GPT-5/DeepSeek-V3/Qwen3 |
| 嵌入模型 | BGE/E5/GTE | |
| 重排序模型 | BGE-Reranker/ms-marco-MiniLM | |
| 分类模型 | 通常是经过微调的小尺寸模型 |
① 根据模态分类
根据模态,可以将大模型分为:语言大模型、多模态理解大模型和多模态生成大模型。
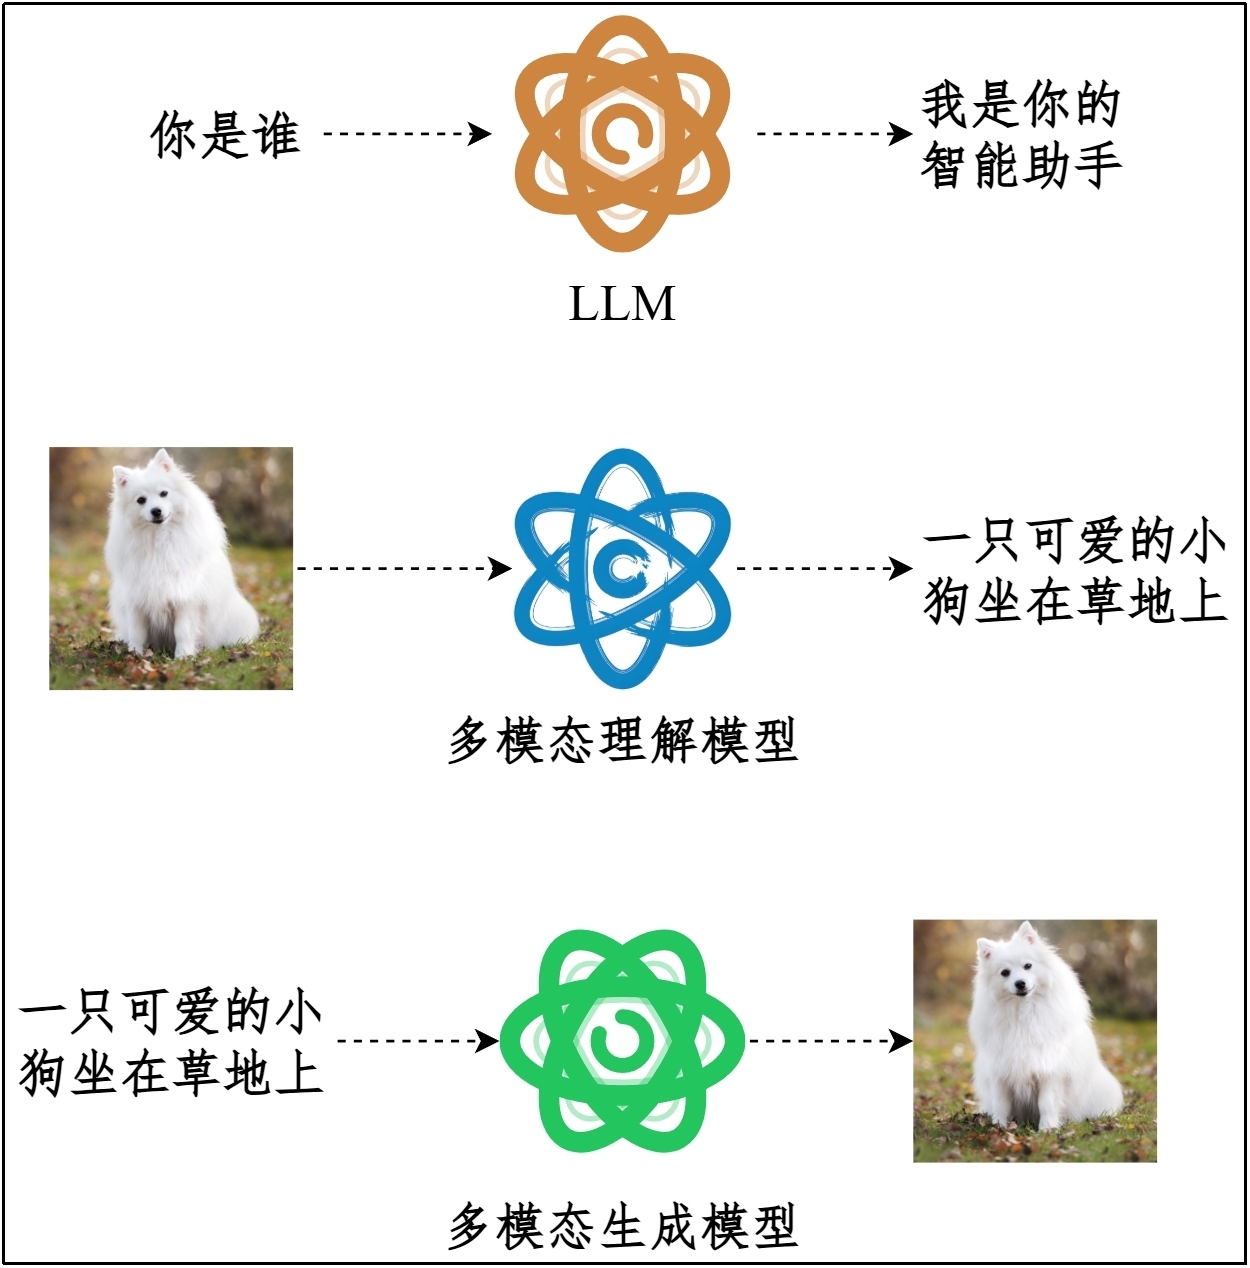
注意:如果没有特别说明,“大模型”通常是指“语言大模型”。
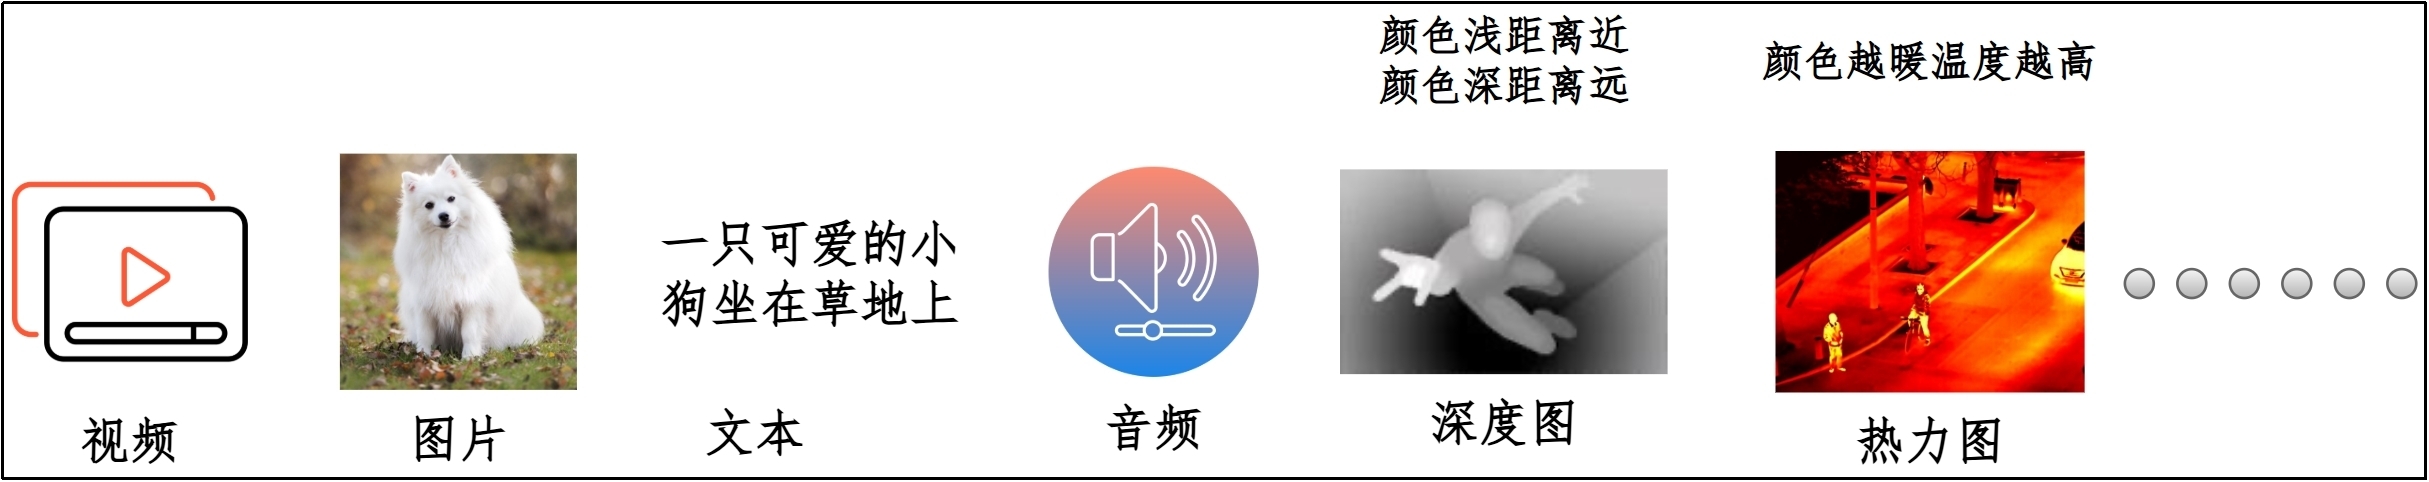
什么是模态(Modality)?
模态是指人或机器感知世界的方式,常见的模态有:文本、图像、音频/语音、视频等。
类型1:大语言模型(Large Language Model,LLM)
又称为语言/文本大模型(Language/Text Model),专门处理文本数据的AI模型
(1)输入/输出
输入:文本
输出:文本(token序列)
(2)技术架构:Transformer文本编码
(3)典型应用:对话、写作、推理、翻译、代码生成
(4)示例:Qwen3系列 / DeepSeek-V3.2系列 / GPT-5系列(语言模块) / Gemini-3系列(语言模块)
注意:ChatGPT和Gemini都是一个以语言大模型为中枢的智能体系统,是面向用户推出的AI产品,支持文本生成、图像理解和生成。并
不属于单一的某一类。
类型2:多模态理解大模型(Multimodal Understanding Model)
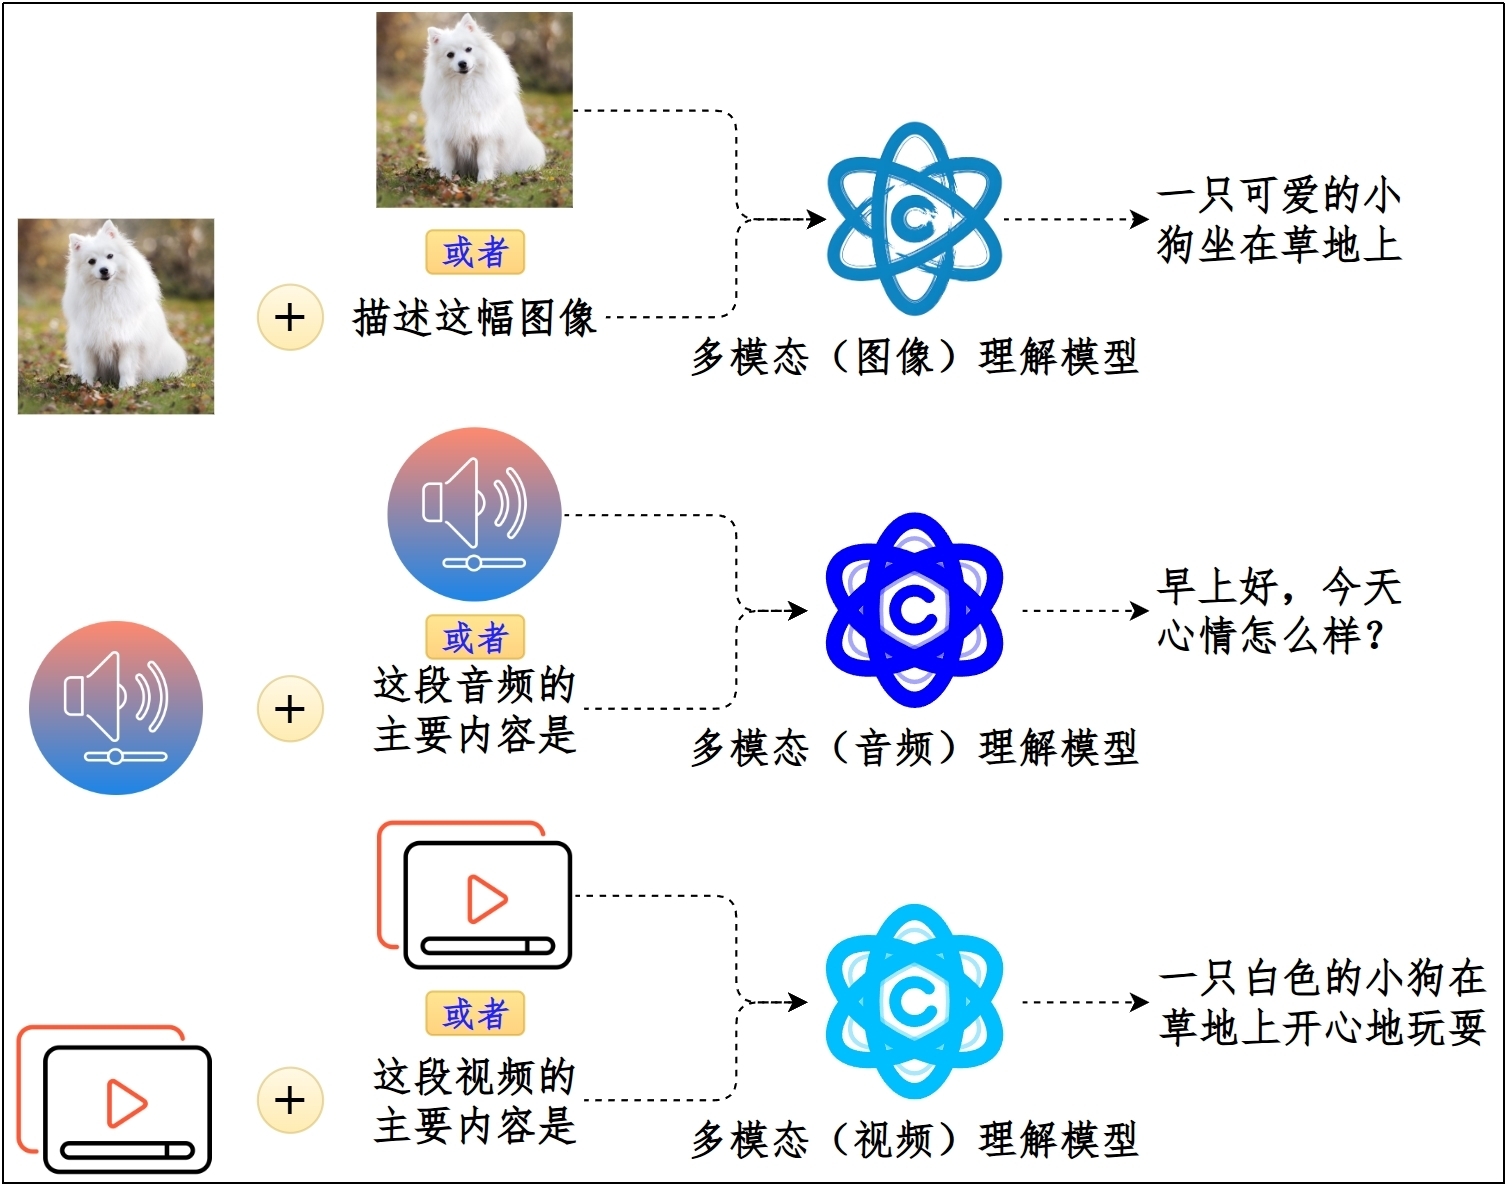
多模态理解大模型,能够同时处理和理解多种类型的数据,包括文本、图像、音频、视频等。通过对比学习等技术将不同模态映射到统一语义空间。
(1)输入/输出:
输入:文本 + 图像 / 音频 / 视频
输出:通常是文本
(2)技术架构:多编码器+跨模态融合
(3)典型应用:看图说话(VQA)、视频理解、音频理解、文档理解(PDF / 表格 / 图像)
(4)示例:GPT-5系列 / Qwen3-VL系列 / Gemini-3系列
类型3:多模态生成模型(Multimodal Generative Model)
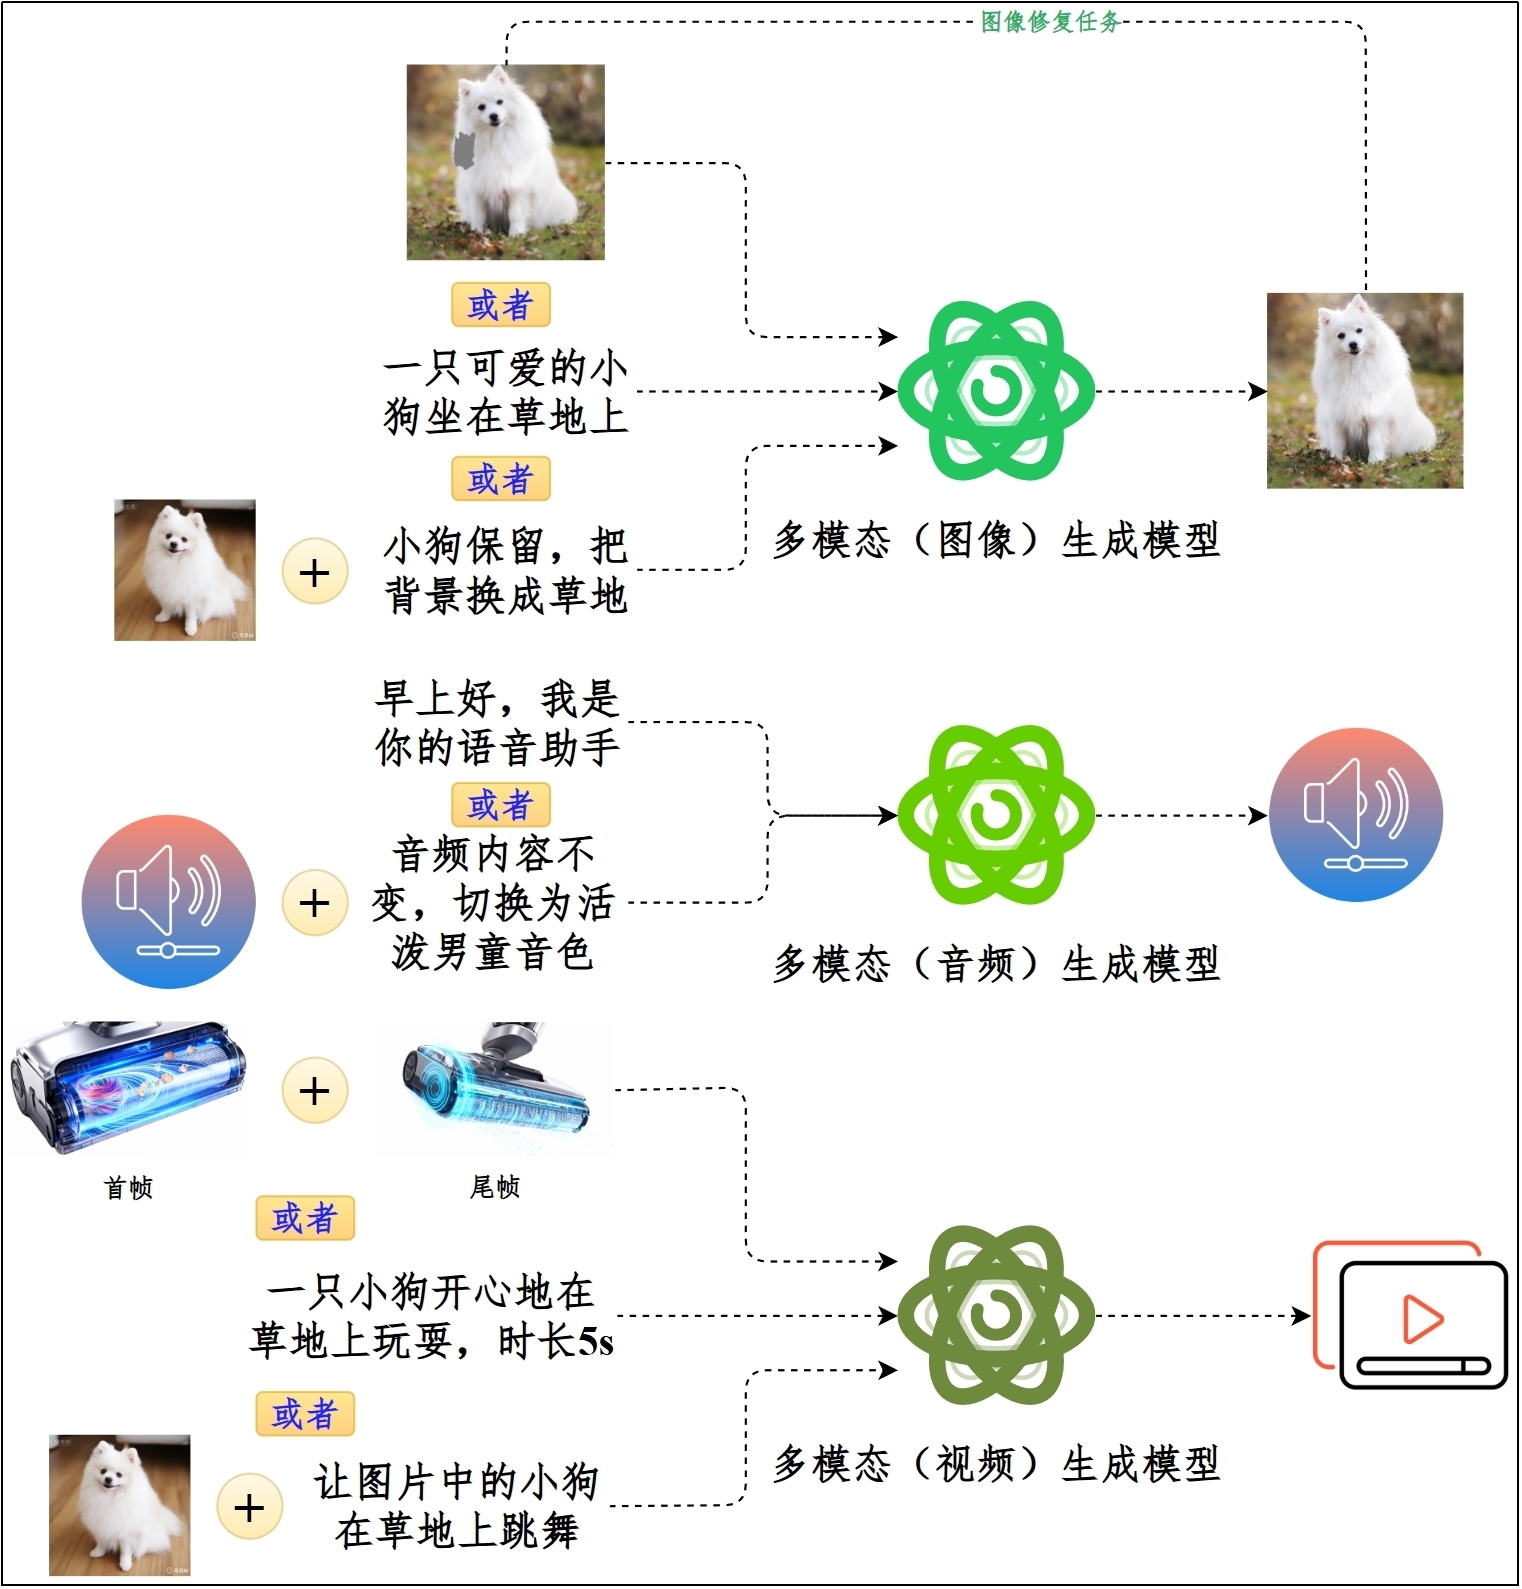
多模态生成模型,不仅能够理解多种模态,还能实现跨模态的内容生成。其核心是生成式架构,通过扩散模型、自回归生成等技术实现从一种模态到另一种模态的转换。
(1)输入/输出:
输入:文本 / 图像
输出:图像 / 视频 / 音频
(2)技术架构:生成式架构(扩散/自回归)
(3)典型应用:文生图(Text-to-Image)、文/图片生视频(Text/Image-to-Video)、文生音频(TTS / Music)
(4)示例
图像生成:Stable Diffusion系列 / DALL·E / GPT-Image-1.5 / Nano-Banana系列
视频生成:Sora系列 / Veo系列
音频生成:AudioLM / VALL-E
② 按模型功能/输出形态分类
按“模型输出的数学形态 + 使用方式”分类,可以分为:生成式大模型、嵌入模型、重排序模型、分类模型。
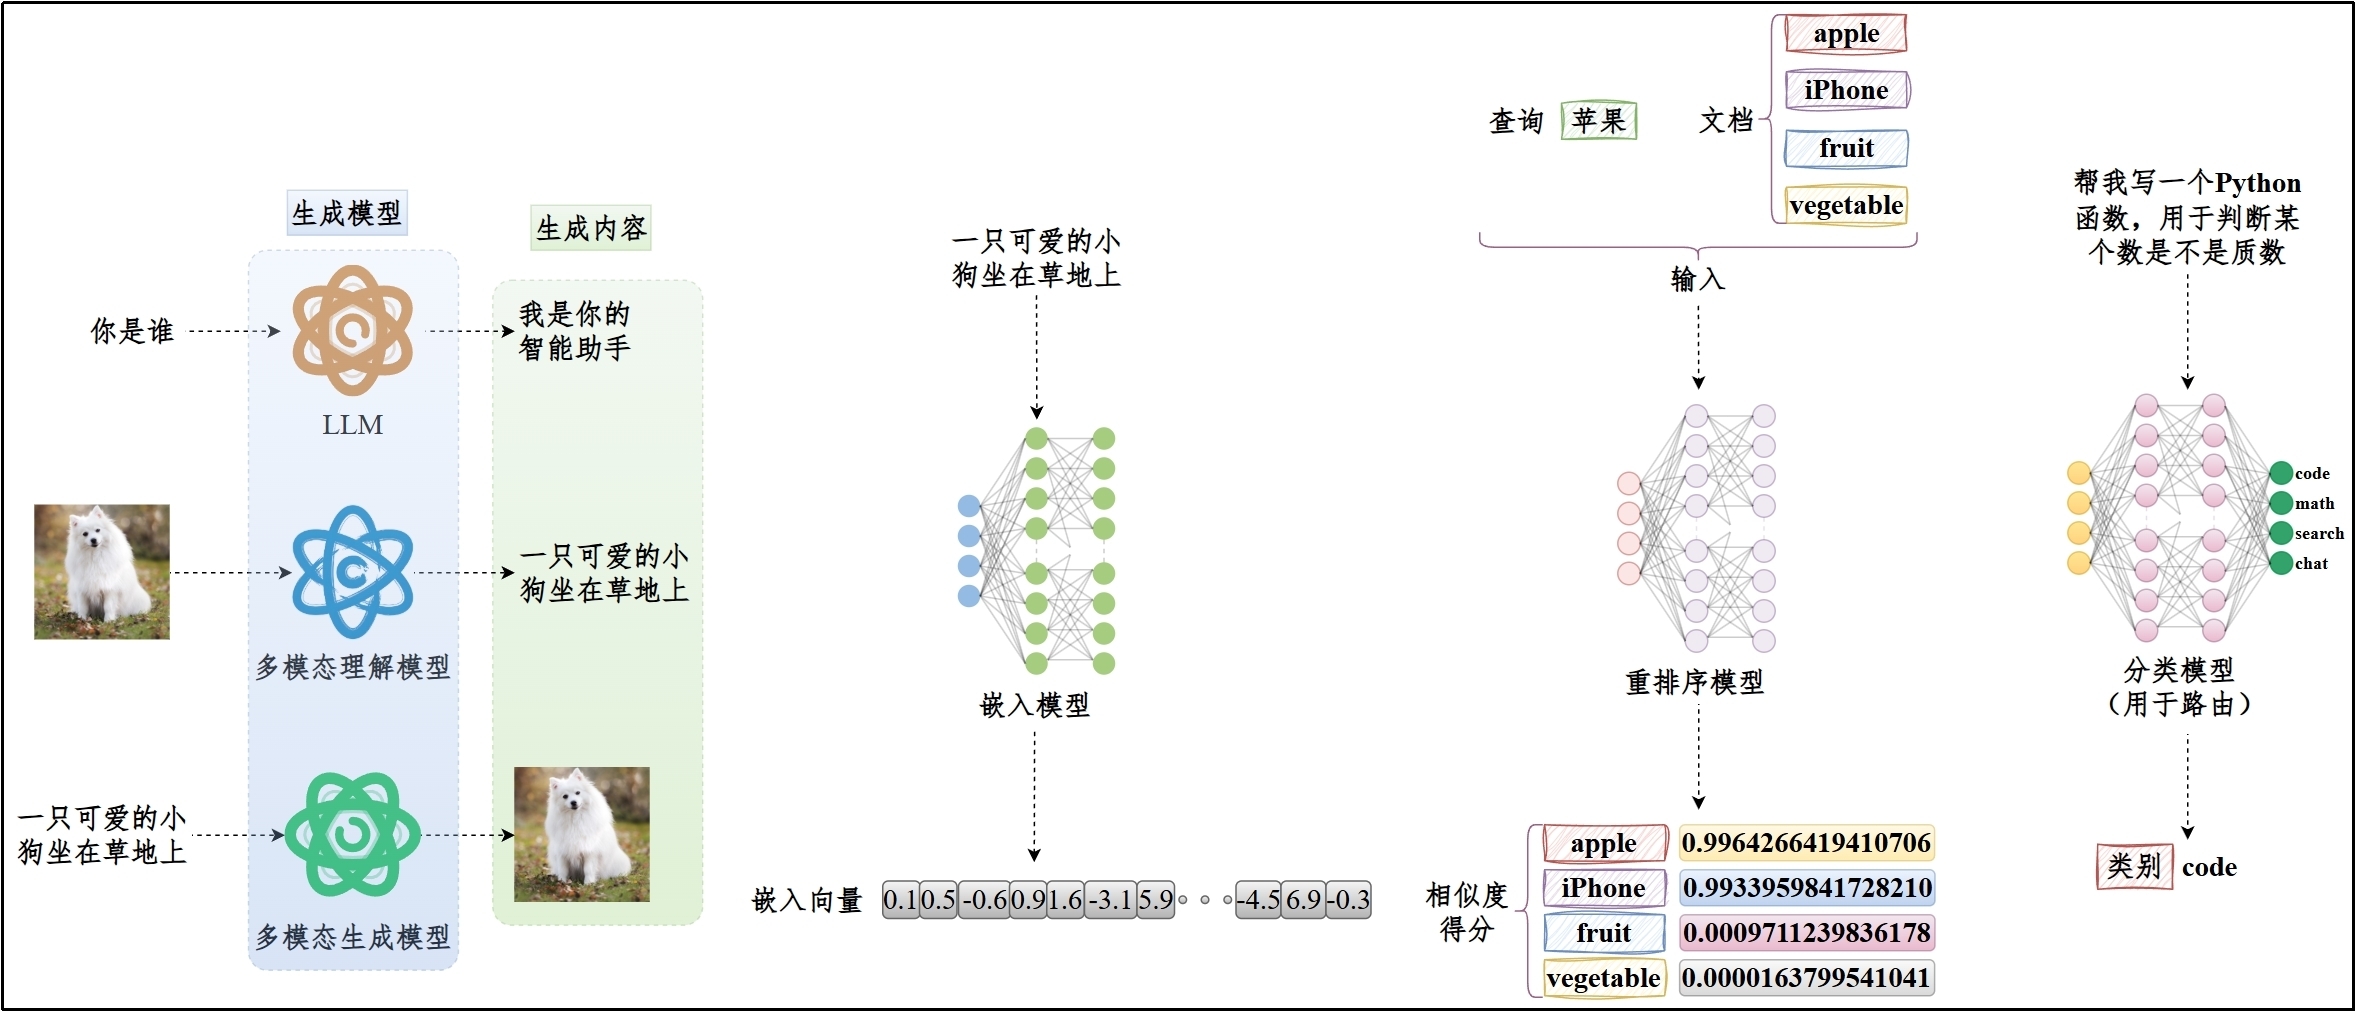
类型1:生成式大模型(Generative LLM)
能够根据指令或提示,从无到有生成原创内容,包括文本、图像、音频、视频等。
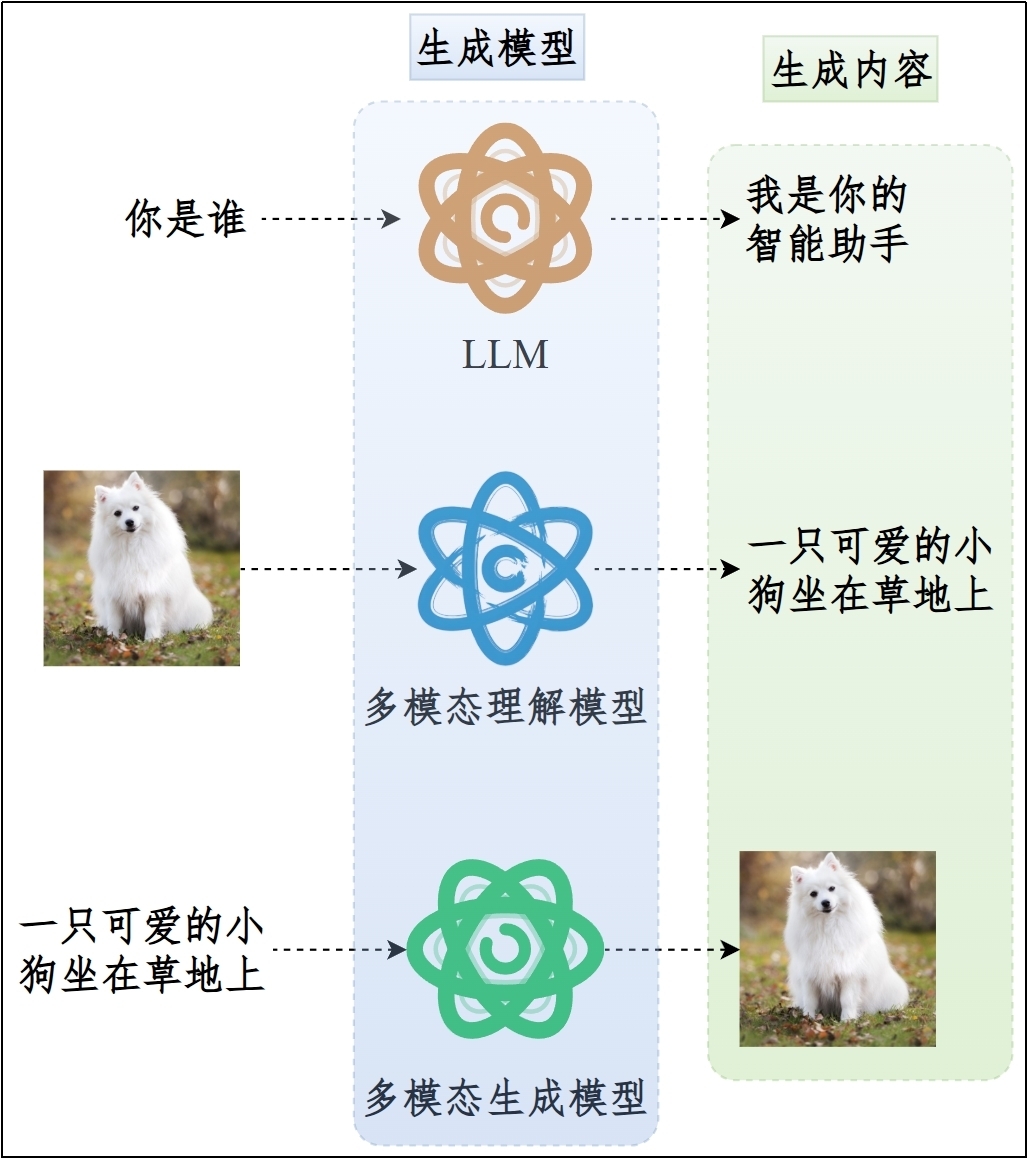
(1)说明
输出:token序列
目标:最大化条件概率P(token | context)
(2)典型应用:对话、推理、Agent、RAG最终回答生成
(3)示例:GPT-5系列 / DeepSeek-V3系列 / Qwen3系列 / DALL-E图像生成、Sora视频生成
(4)核心特征:自回归(Autoregressive)生成,即不断预测下一个Token以产出内容。
类型2:嵌入模型/向量表征模型(Embedding Model / Representation Model)
将文本、图像等离散数据转换为高维向量表示,在向量空间中捕捉语义关系。语义相似的文本在向量空间中距离更近,便于快速检索和比较。
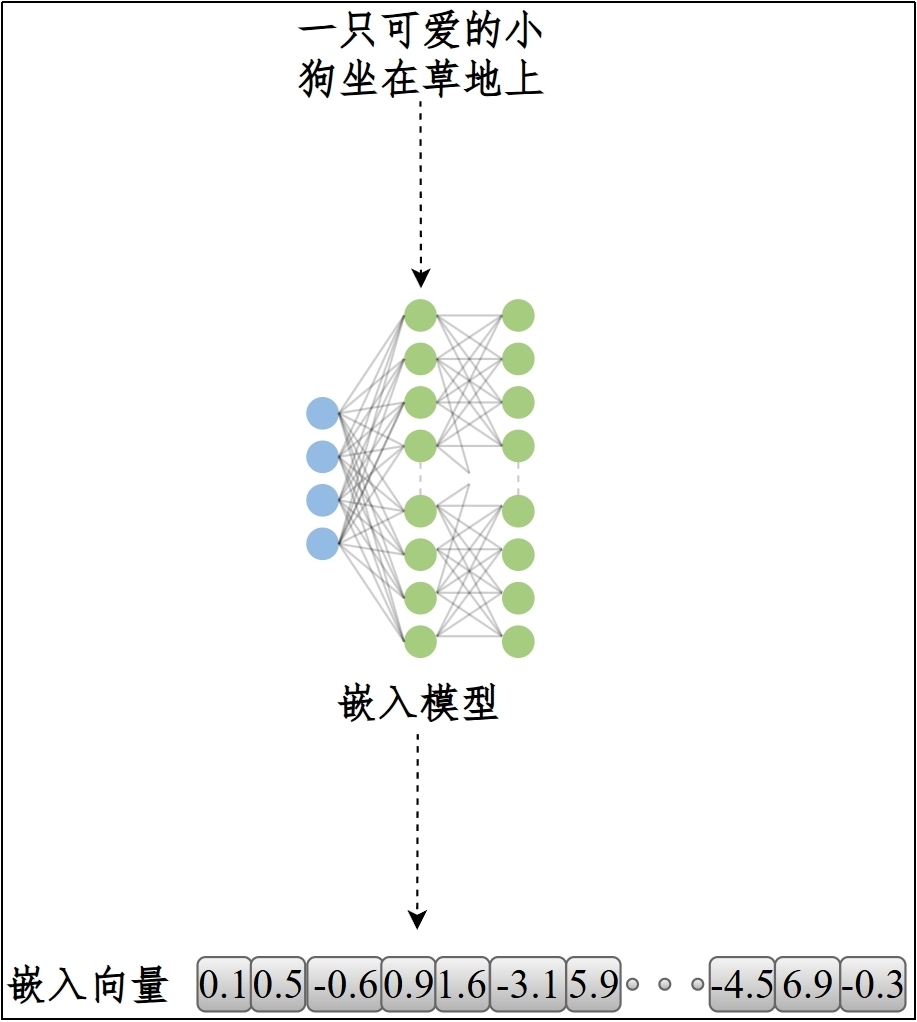
(1)说明
输出:固定维度向量(dense vector),不生成文本
(2)典型应用:语义搜索、推荐系统、知识库检索、文档相似度计算
(3)示例:BGE系列 / E5系列 / GTE系列
类型3:重排序 / 相关性打分模型(Reranking / Scoring Model)
对初步检索结果进行精细化排序,通过深度语义分析重新计算查询与文档的相关性得分,将最相关的内容排在最前面。
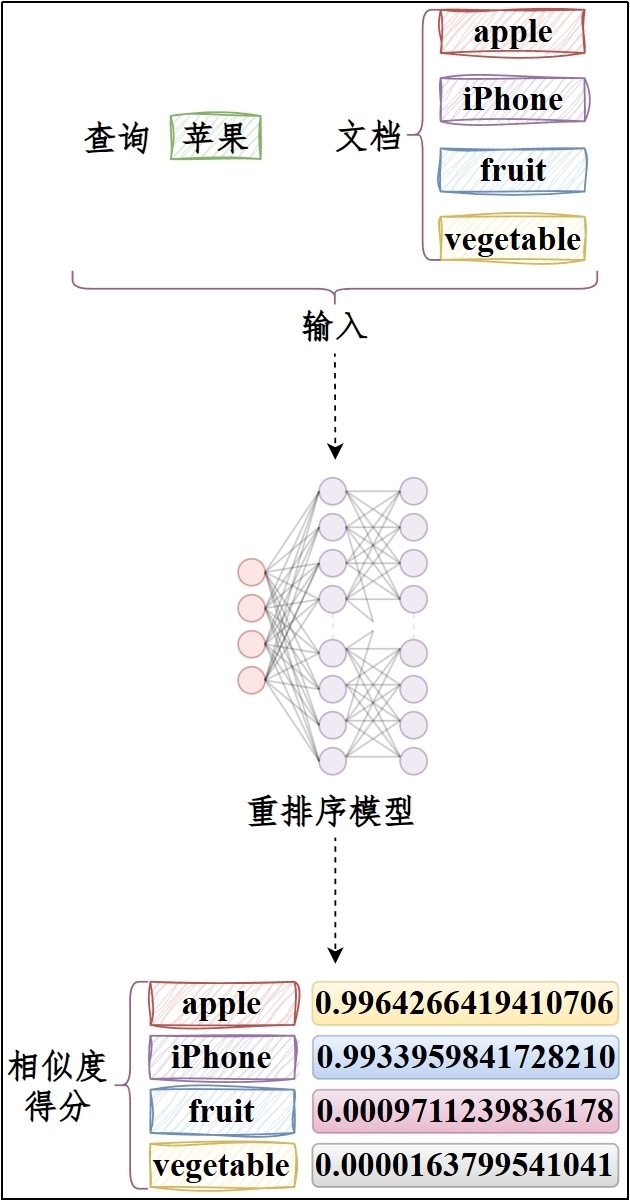
(1)输入/输出:
输入:(query, doc)
输出:相关性分数(scalar)
(2)典型应用:RAG系统中的检索结果优化、搜索引擎的排序优化、推荐系统的精排阶段
(3)示例:BGE-Reranker系列 / Cross-Encoder的ms-marco-MiniLM系列
(Cross-Encoder是Huggingface的一个Organization,训练了很多Text Reranking模型)
类型4:分类器 / 判别模型(Classifier / Judge Model)
根据数据特征预测其所属的预定义类别,输出离散的类别标签或概率分布。
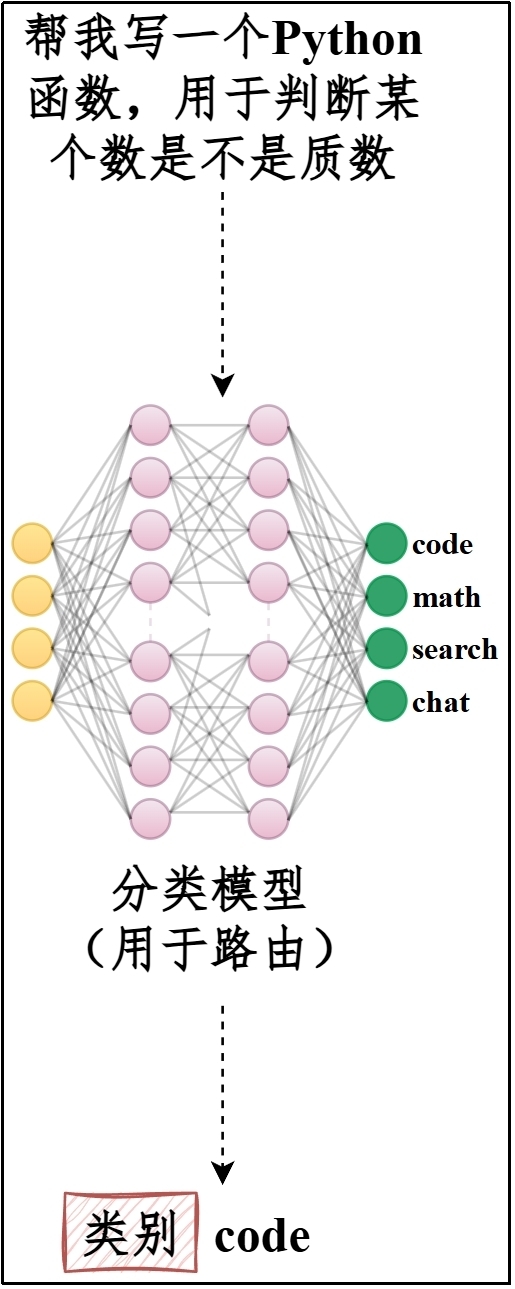
(1)输出:标签 / 概率 / Yes-No
(2)典型应用:垃圾邮件识别、情感分析、图像分类、疾病诊断等二分类或多分类任务
(3)示例:通常是经过微调的小模型,如基于BERT微调的分类模型。
小结:四者关系对比
| 维度 | 生成式大模型 | 嵌入模型 | 重排序模型 | 分类模型 |
|---|---|---|---|---|
| 核心任务 | 内容生成 | 语义编码 | 相关性排序 | 类别预测 |
| 输出形式 | 自然语言/图像/音频 | 高维向量 | 相关性分数 | 类别标签 |
| 模型规模 | 百亿~千亿参数 | 百万~亿级参数 | 千万~亿级参数 | 百万~千万参数 |
| 计算成本 | 极高 | 极低 | 中低 | 低 |
| 典型架构 | Transformer解码器 | Transformer编码器 | 交叉编码器 | 逻辑回归/SVM/决策树 |
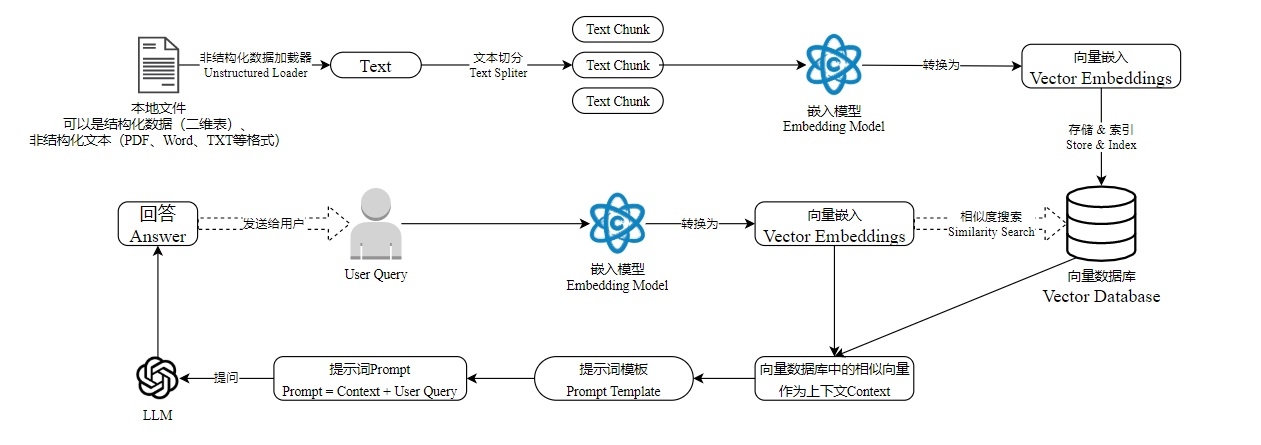
协同工作流程:
在实际应用中,这四类模型往往协同工作:
嵌入模型将知识库文档转换为向量存入向量数据库 --->
用户查询时,先用嵌入模型检索候选文档 ---> 重排序模型对候选结果进行精排 --->
分类模型可能用于过滤或分类 ---> 最终由生成式大模型基于精排结果生成答案。
这种组合架构在RAG系统中广泛应用,实现了检索与生成的完美结合。
1.5 大模型的开源vs闭源
1.5.1 大模型四要素
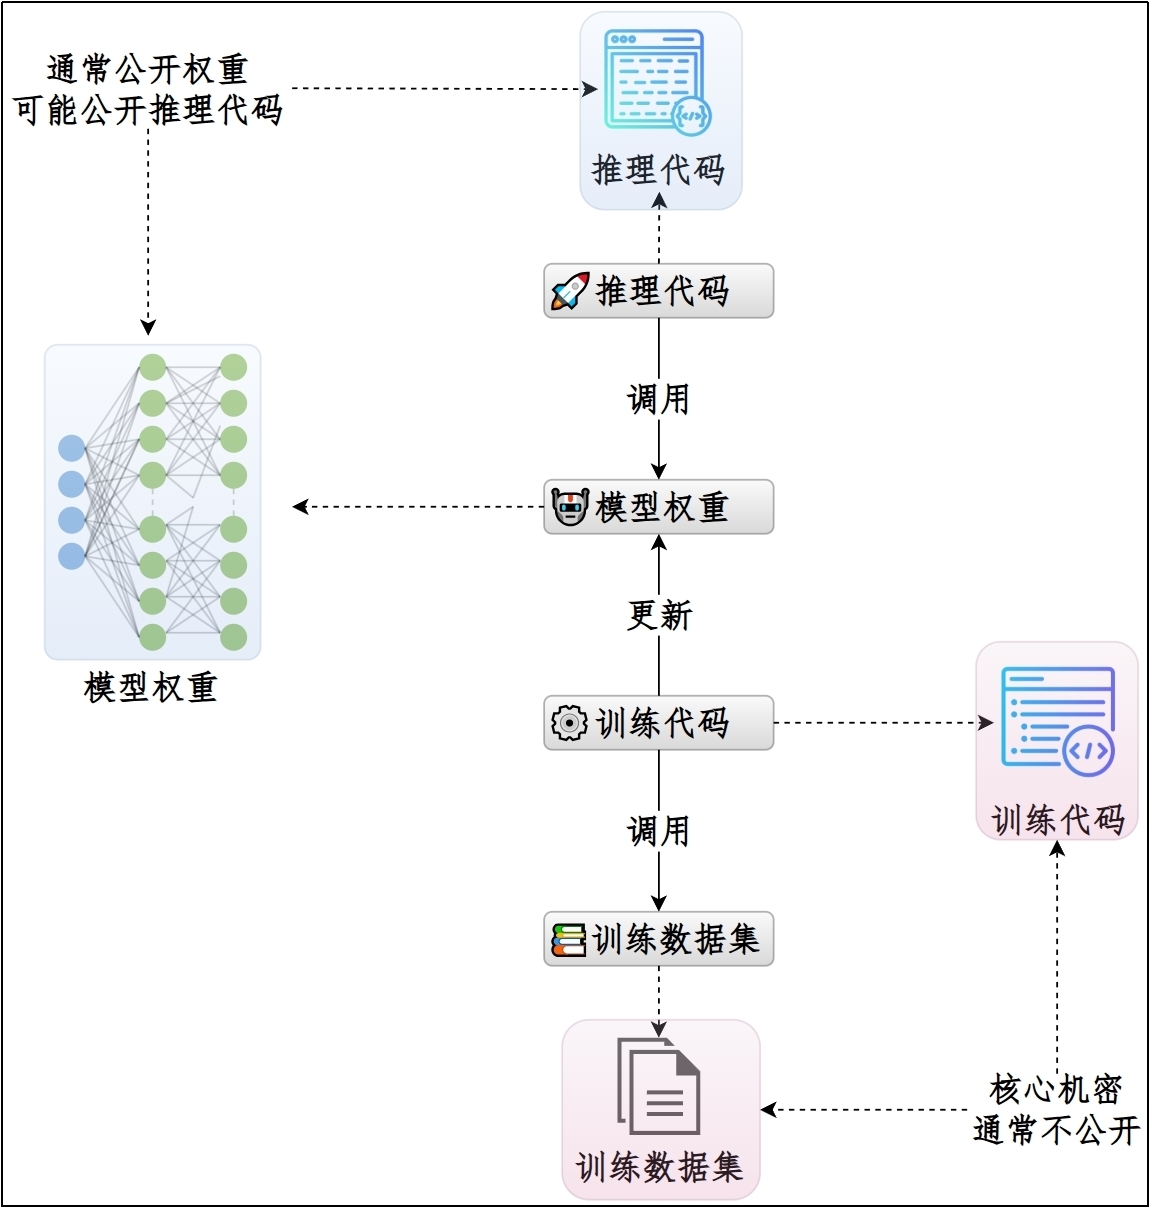
大模型由四个要素构成:模型权重(参数)、推理代码、训练代码、训练数据集。
四个要素的调用关系:
1.5.2 开源 vs 闭源大模型
开源大模型:不同于传统软件的开源,大模型开源主要指开源权重(模型参数),可能包含推理代码,通常不包含训练代码和数据集。任何人都可以查看、修改和分发。
典型代表:DeepSeek系列、Qwen系列、Llama系列、文心大模型4.5。
闭源大模型:特定企业开发并保密,源代码和内部实现不对外公开。
典型代表:GPT系列(不包括早期的GPT-1、GPT-2,以及最近开源的GPT-OSS系列)、Gemini系列(大多数)、Claude系列。
开源 vs 闭源对比:
| 维度 | 开源大模型 | 闭源大模型 |
|---|---|---|
| 透明度 | 代码和算法完全透明,可审查验证 | 内部机制不透明,存在"黑箱"问题 |
| 可访问性 | 免费使用,降低技术门槛 | 需要特定许可或授权,通常付费 |
| 定制性 | 支持深度定制和优化 | 定制能力受限,仅限API参数调整 |
| 创新速度 | 社区协作推动快速迭代 | 依赖单一团队,创新速度较慢 |
| 成本结构 | 免费使用,但需硬件和运维投入 | 按使用量付费,前期投入低但长期成本高 |
| 技术支持 | 依赖社区,缺乏官方专业支持 | 提供企业级技术支持和维护服务 |
| 安全性 | 透明可审计,但可能被恶意利用 | 代码不公开,保护知识产权和用户数据 |
1.5.3 核心策略与商业考量
开源大模型的商业逻辑
核心策略:技术扩散换取生态影响。开源企业通过"免费厨房"模式吸引开发者,构建庞大的用户生态,最终通过云服务、工具链、行业解决方案等增值服务实现盈利。
具体变现路径:云服务变现、企业级定制、硬件生态、工具链和平台等
优势:快速占领市场、建立行业标准、降低用户采用门槛,形成"创新飞轮"效应——企业贡献基础模型,学术界优化算法,开发者创造应用,最终反哺模型迭代。
闭源大模型的商业逻辑
核心策略:专有技术换取商业利润。通过技术垄断建立护城河,通过API调用、企业级定制解决方案、云平台集成等直接变现。
具体盈利模式:API订阅服务、企业级解决方案、技术授权和专利变现、云平台增值服务等
优势:直接盈利能力强、技术溢价高、服务质量稳定、保护知识产权。闭源模式能够保障企业在短期激烈市场竞争中获得利润。
1.5.4 混合模式的兴起
随着市场竞争加剧,许多企业开始采用"开源引流,闭源变现"的混合策略:
谷歌Gemini+Gemma:开源Gemma吸引开发者生态,闭源Gemini专注高利润企业客户Meta:闭源模型用于商业服务,同时开源LLaMA系列模型构建生态阿里巴巴:拥有中国最大的开源模型家族(通义千问系列),同时提供闭源企业级服务百度文心:2025年6月开源文心大模型4.5系列,同时提供闭源API服务
这种模式既能通过开源快速建立生态,又能通过闭源保障商业回报,成为当前主流策略。
本文由傻鸟发布,不代表傻鸟立场,转载联系作者并注明出处:https://shaniao.net/llm/693.html
