3.1 训练 vs 推理
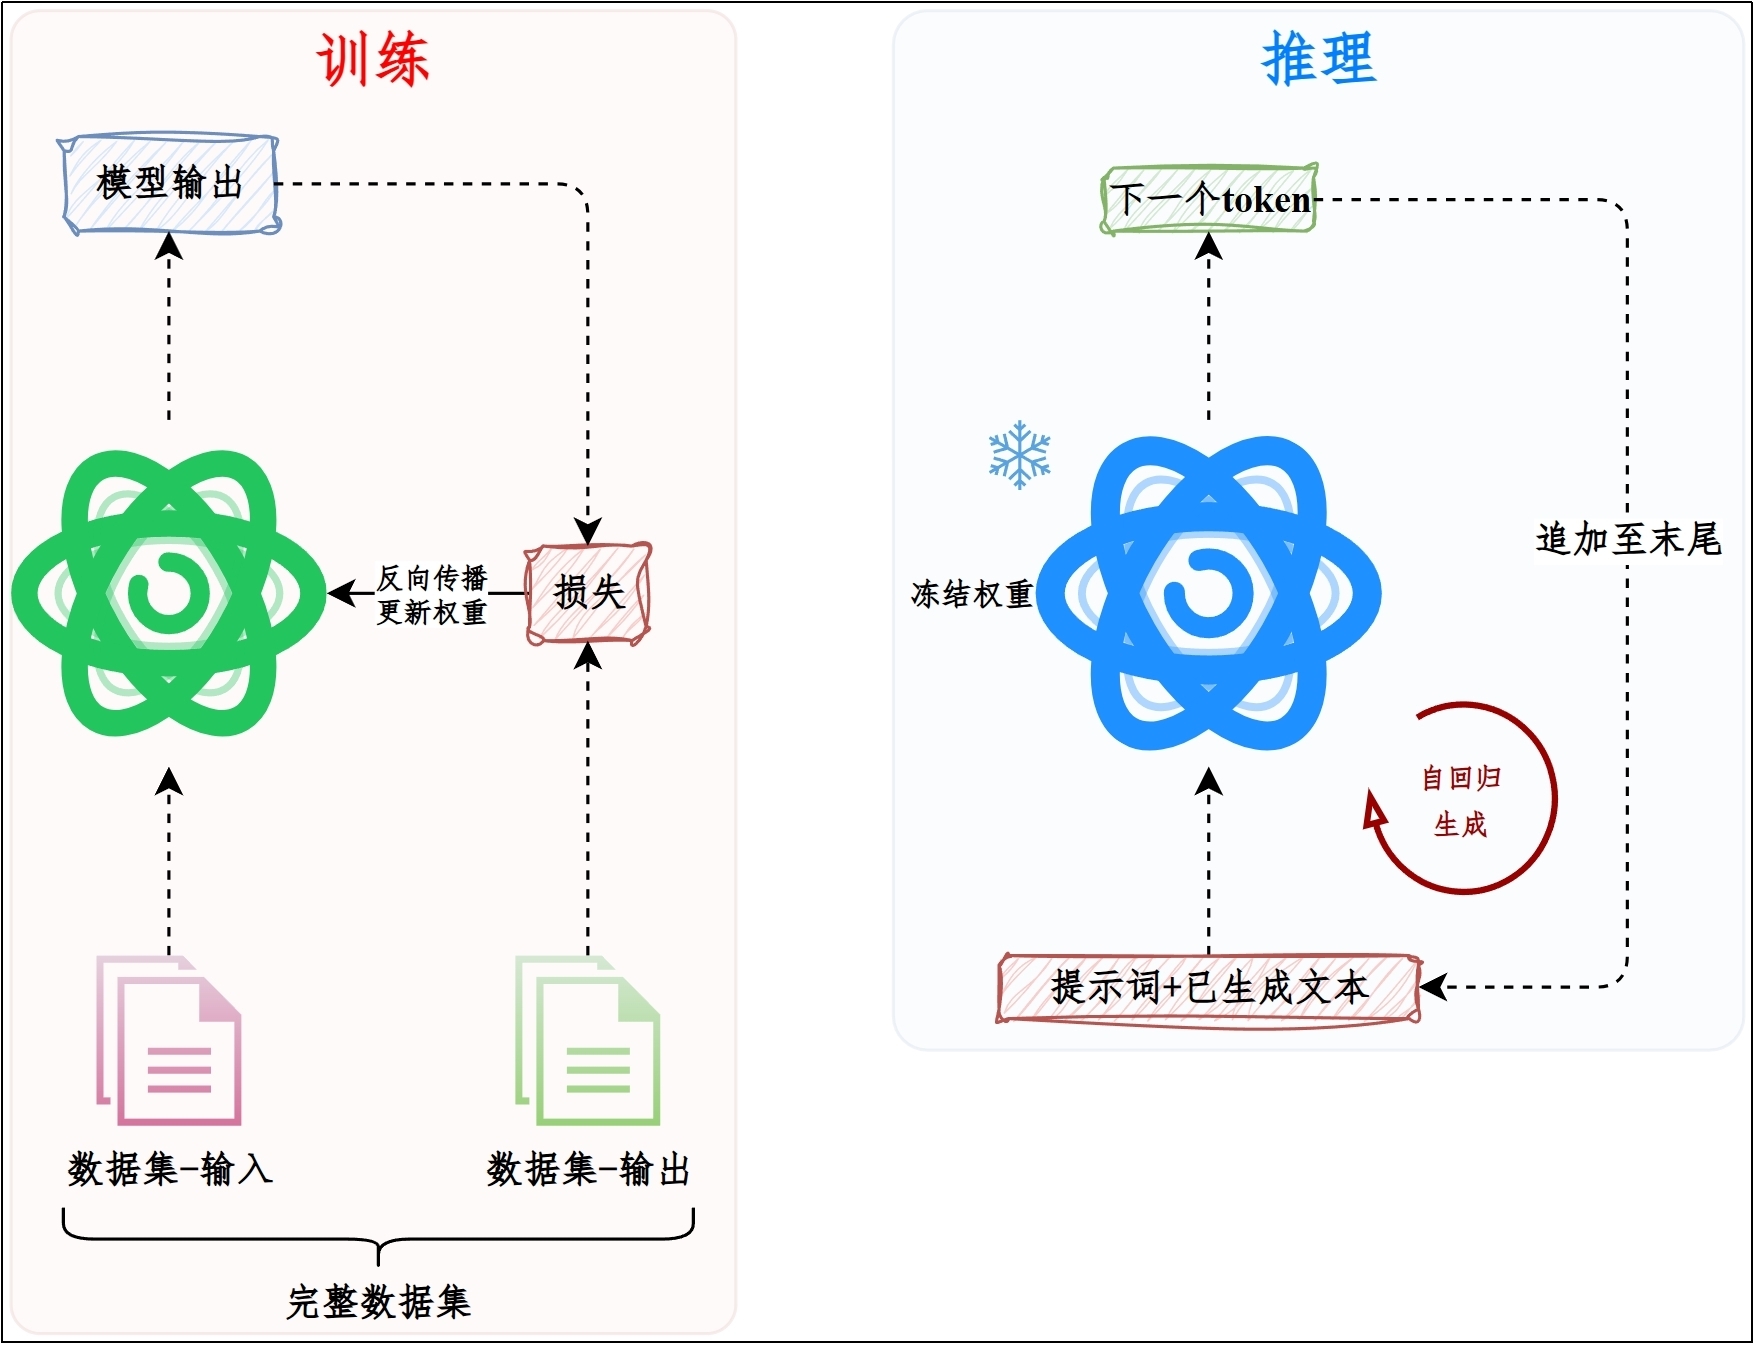
训练(Training)与推理(Inference)是两个完全不同的计算过程:
训练:对大量样本做前向计算,计算损失,再反向传播更新参数;目标是“学到能力”。
推理:参数固定,只做前向计算生成输出;基于输入(提示词)自回归生成。
3.2 算力从哪里来?
3.2.1 算力的定义
算力(Computing Power)是指计算系统在单位时间内完成计算任务的能力,是衡量计算平台性能的核心指标之一。在人工智能领域,算力通常体现为对大规模矩阵运算、张量运算和并行计算任务的处理能力。
在深度学习场景下,算力往往以FLOPS(Floating Point Operations Per Second每秒浮点运算次数)作为量化指标,但在实际应用中,显存容量、带宽以及通信效率往往同样成为决定性因素。
3.2.2 硬件基础
1)CPU、GPU、TPU、NPU
(1)CPU
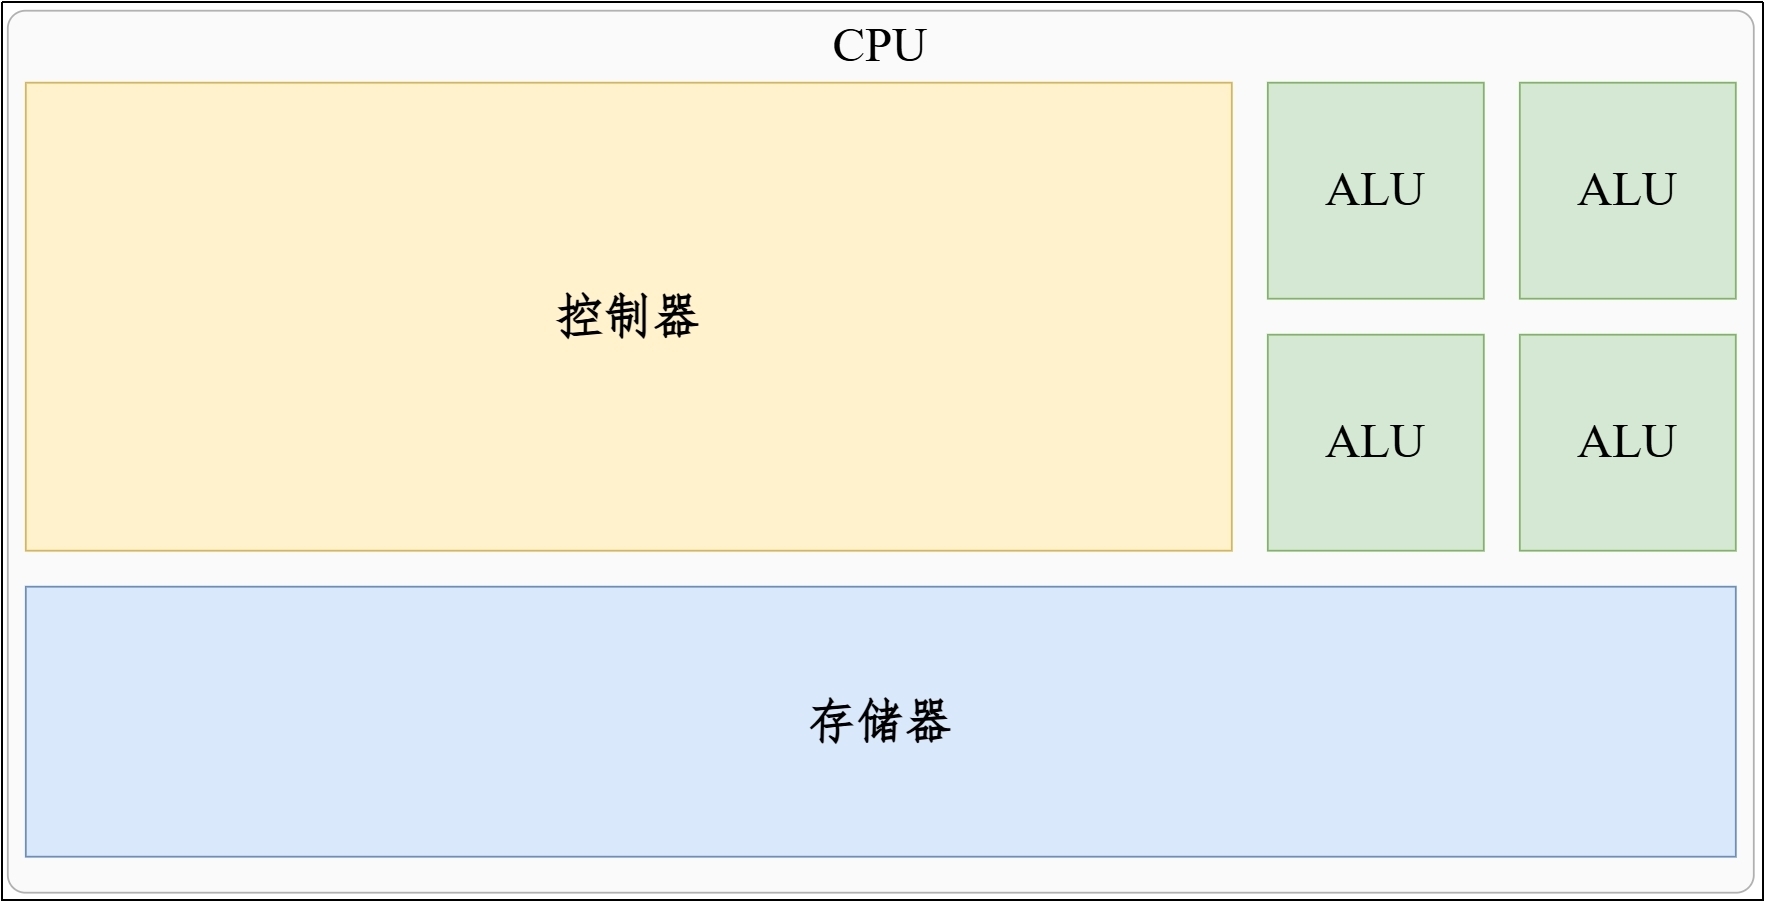
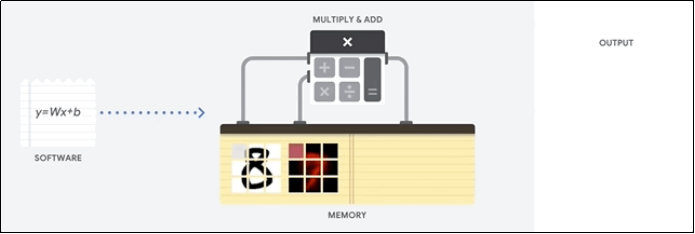
CPU(Central Processing Unit,中央处理器)专为通用计算设计,擅长复杂任务的串行处理,是所有计算机的大脑。如果没有CPU,计算机无法工作。
CPU的运算能力来源于少量性能强大的运算单元:ALU(算数逻辑单元)。
(2)传统GPU
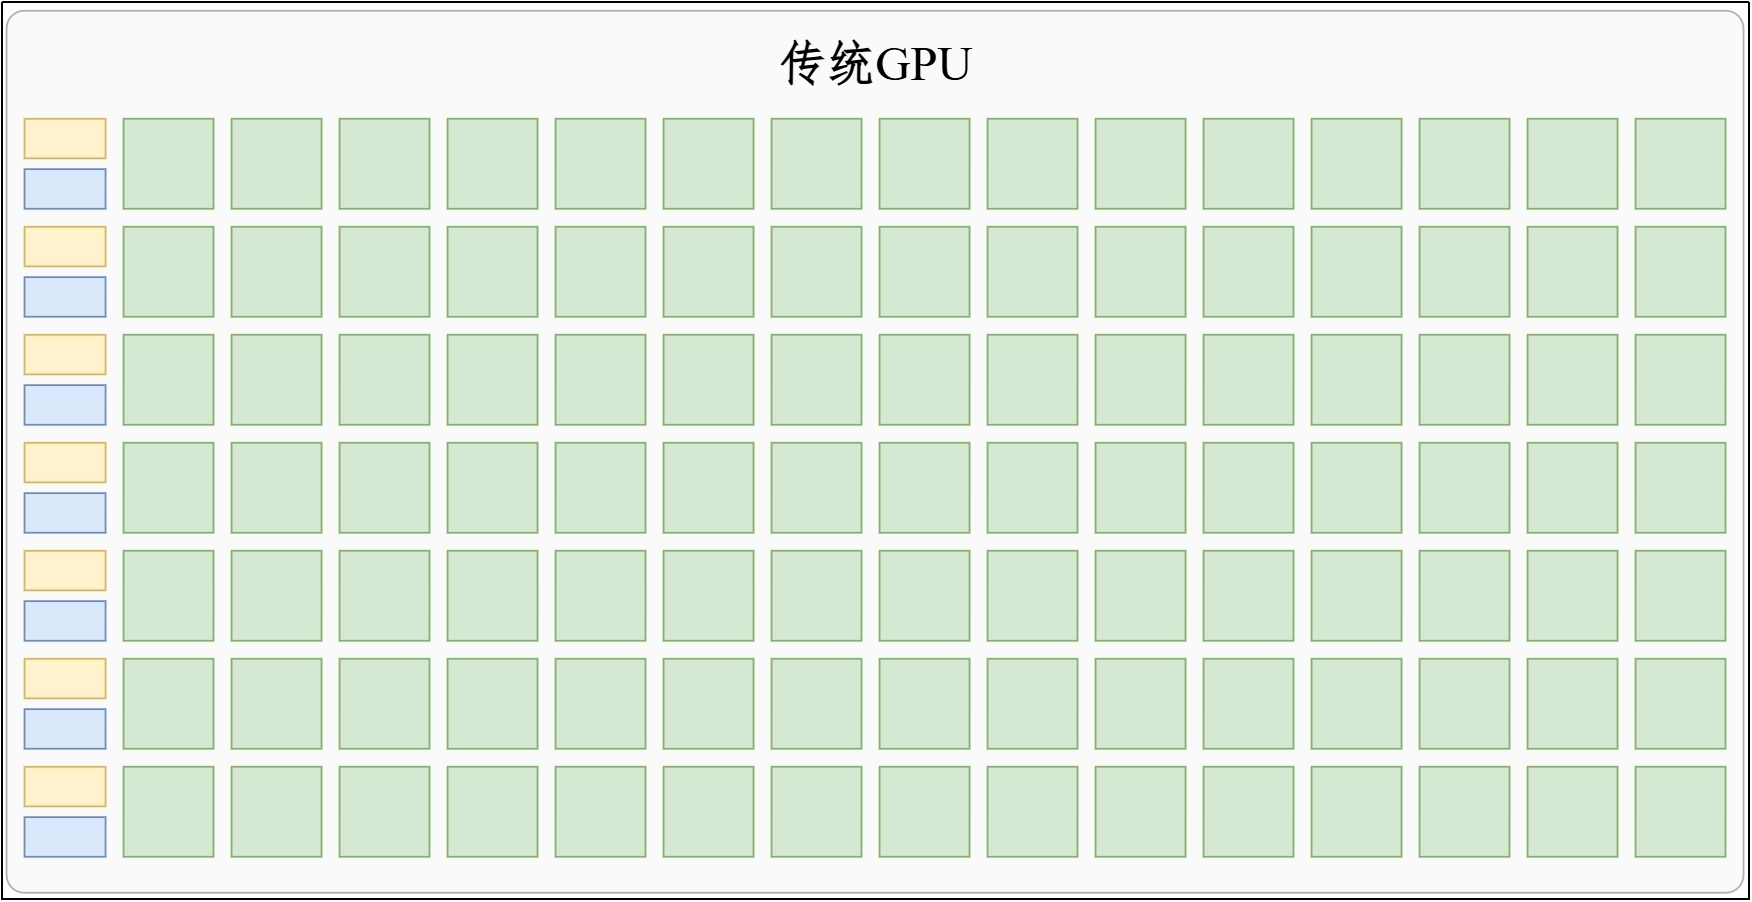
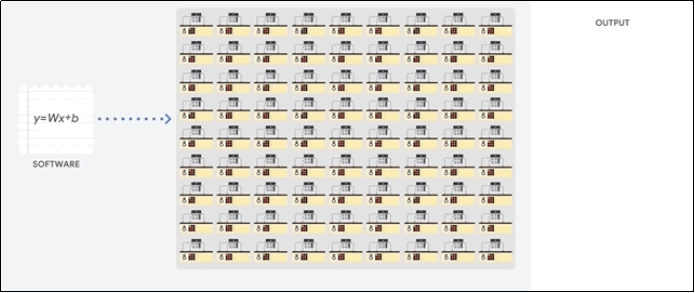
GPU(Graphics Processing Unit,图形处理器)是专用于数字图像处理的电路,我们通常所说的显卡就是GPU,最初设计用于加速图形渲染任务(如3D游戏、视频处理)。
GPU拥有大量功能单一的计算单元(如FP64(专门处理双精度浮点数运算)、FP32、FP16等),适合大量简单任务并行处理。
(3)现代GPU
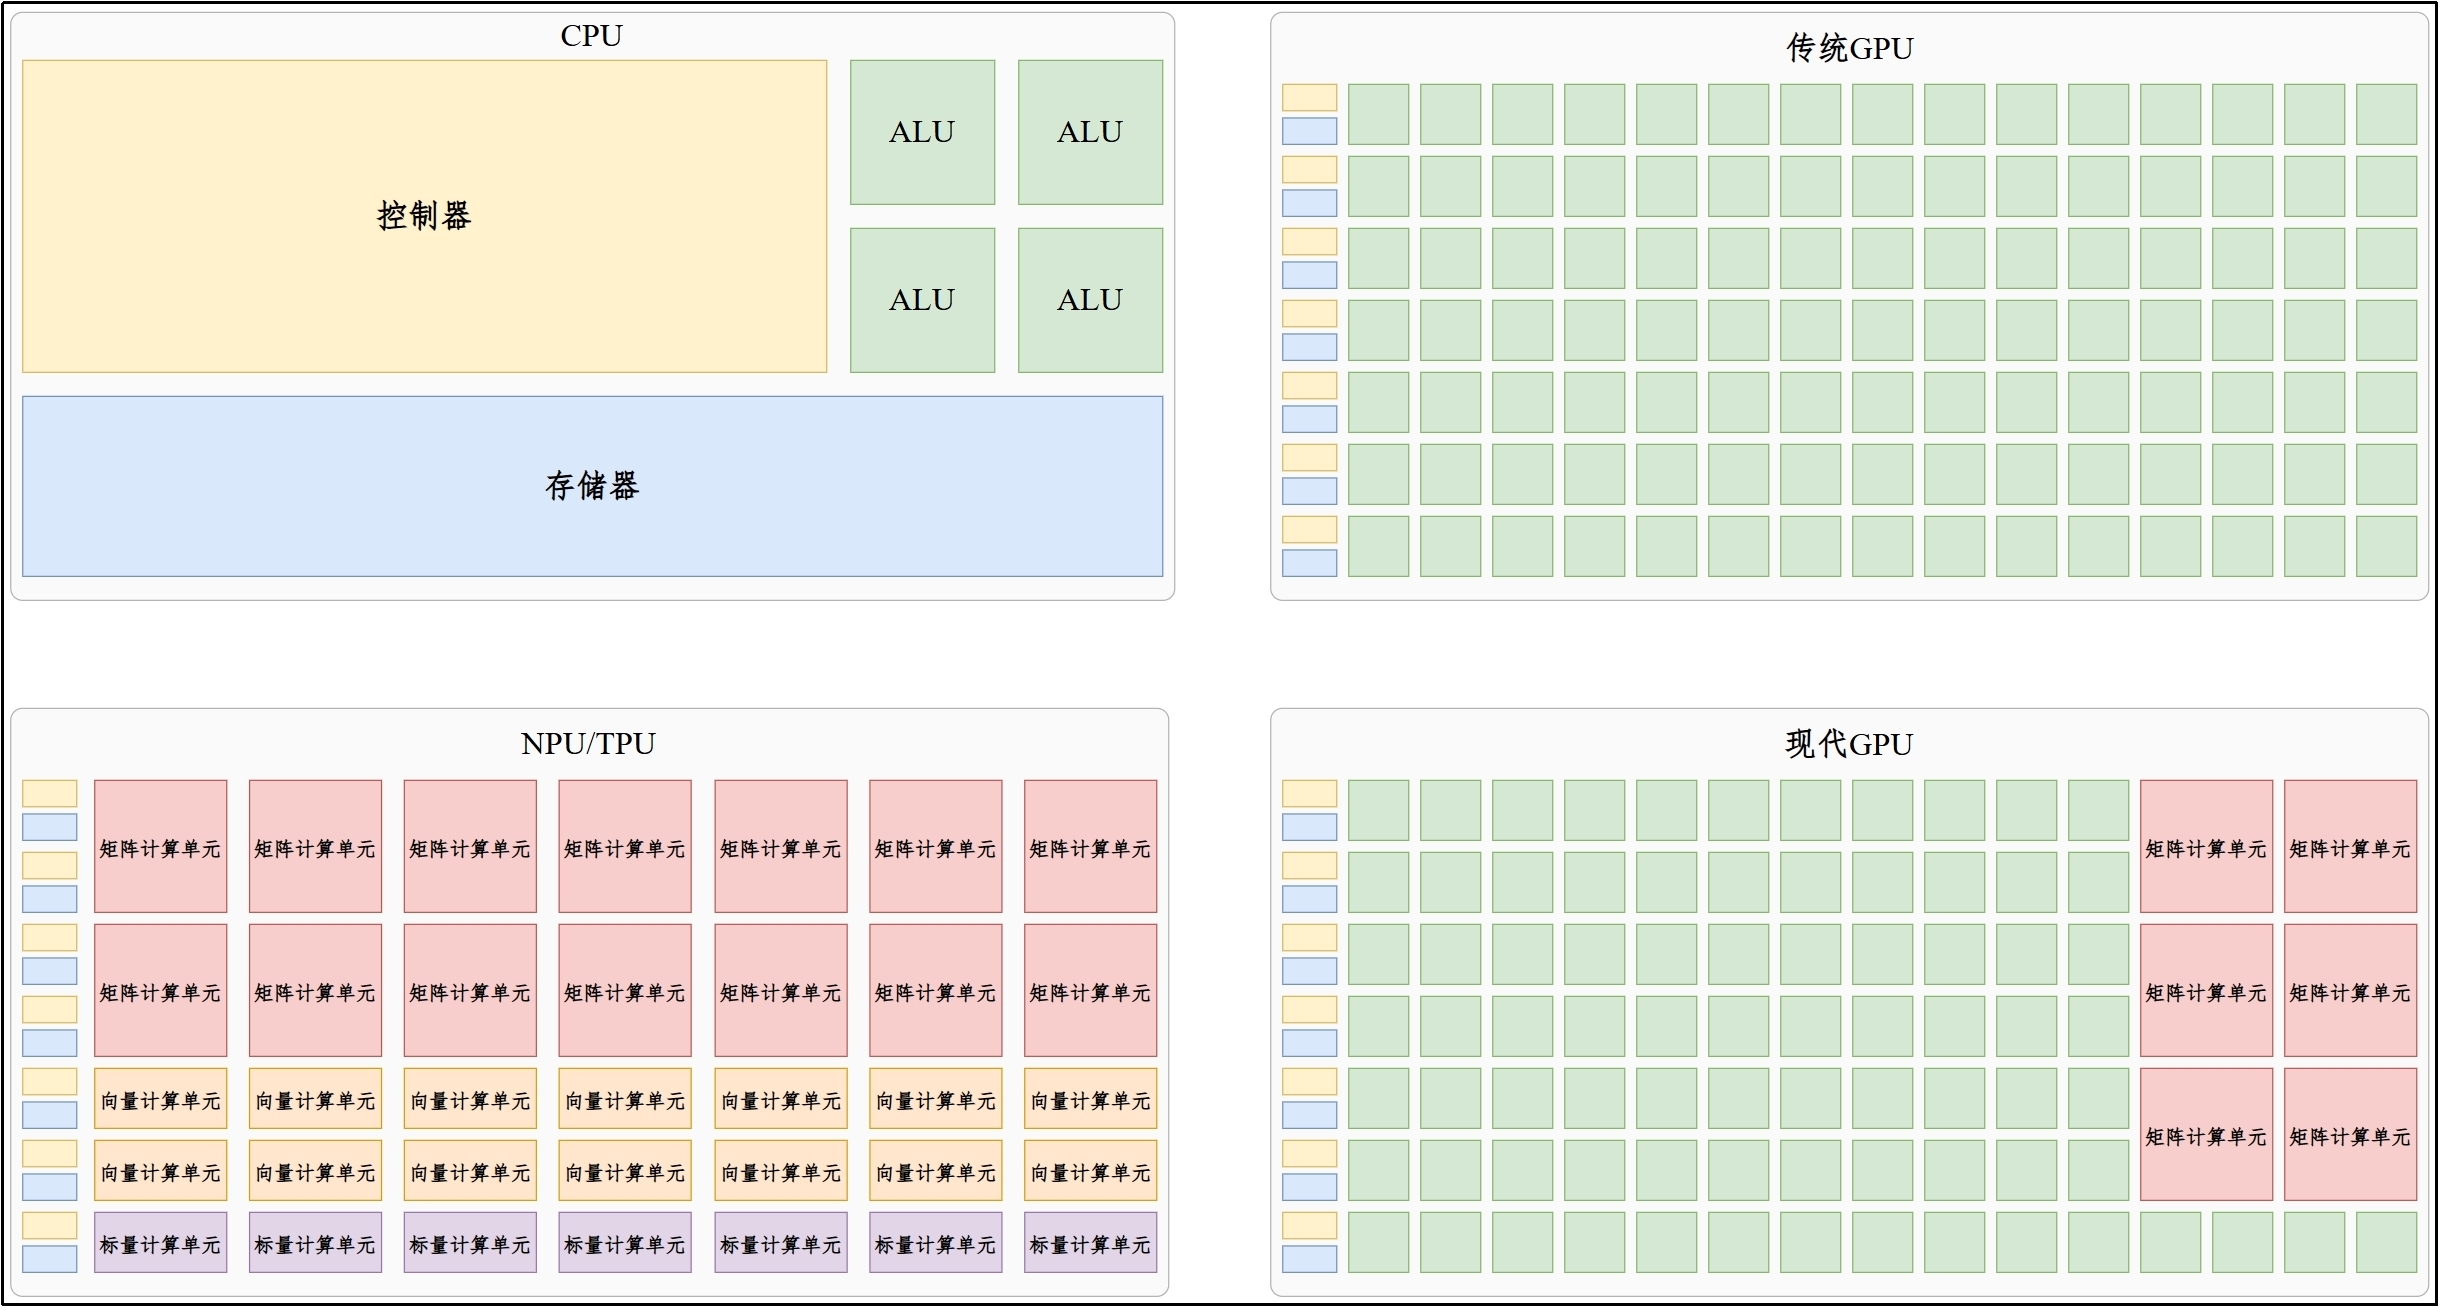
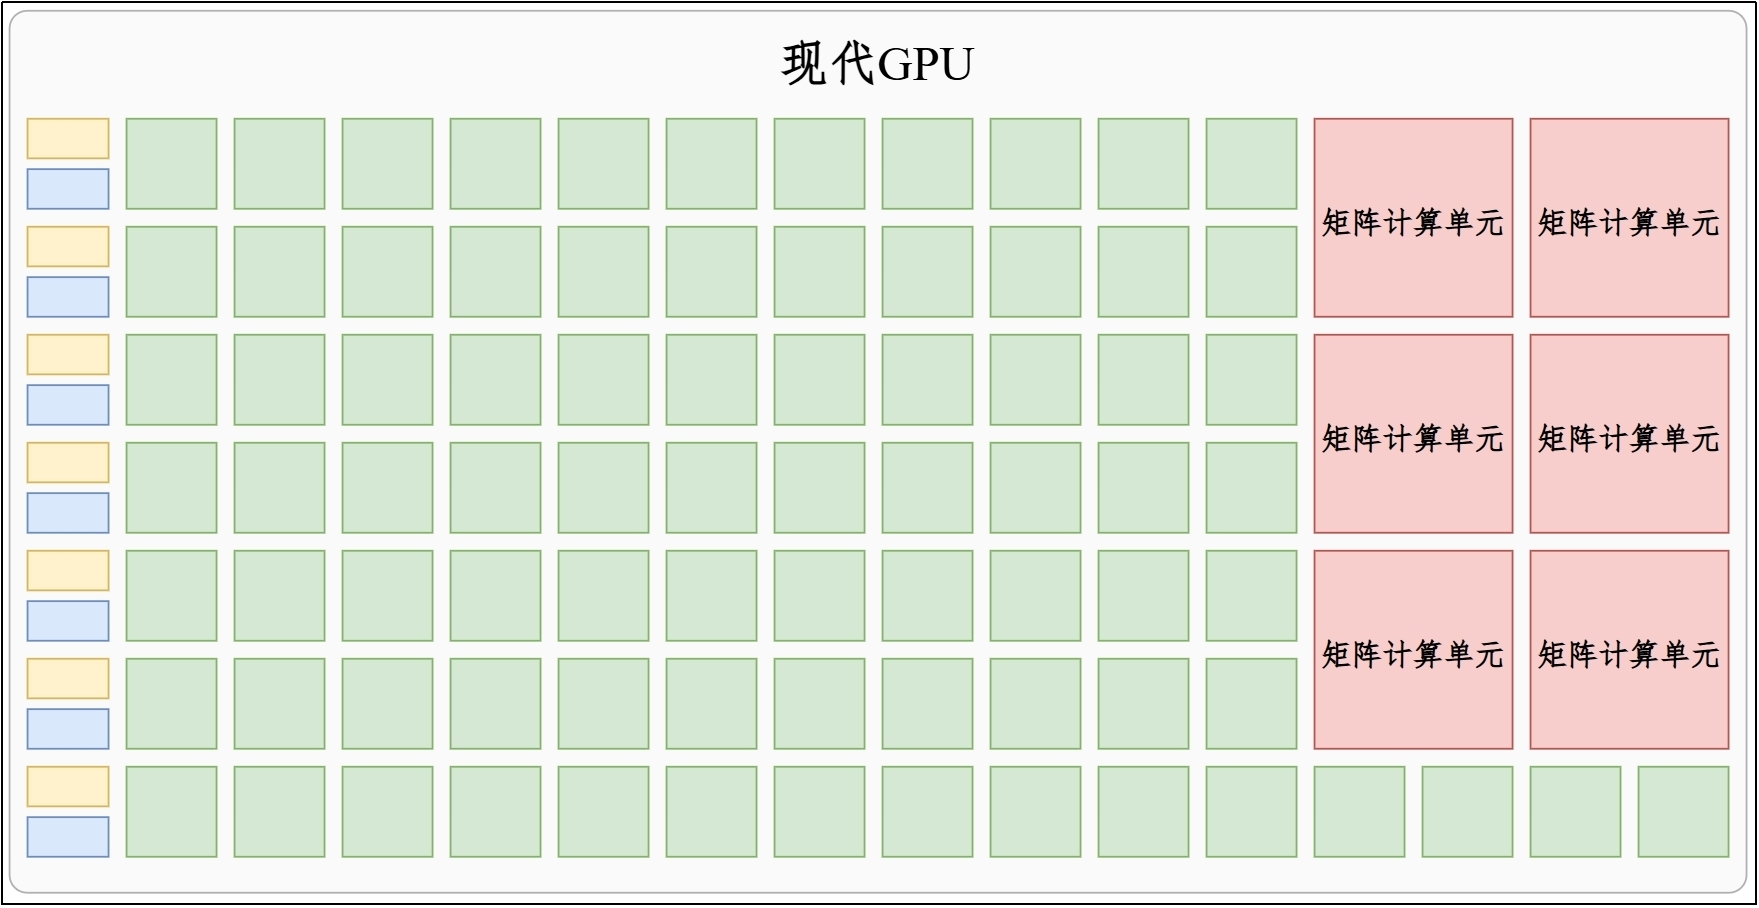
现代GPU为了迎合机器学习训练和推理的需求,在传统GPU的基础上增加了专用的矩阵计算单元,在英伟达显卡中被称为Tensor Core,大幅提升了神经网络计算效率。
目前顶尖的大模型多数都是在英伟达的GPU上训练的。
(4)NPU
NPU(Neural Processing Unit,神经网络处理器),亦称AI加速器或深度学习处理器。是一类专门为加速神经网络计算而设计的芯片,牺牲通用性换取在机器学习任务上的超高性能和低功耗。
NPU砍掉了FP64等单一运算单元,通常只保留矩阵运算单元,并引入向量处理单元和标量处理单元。
说明:NPU厂家很多,架构五花八门,核心思路相同,但具体实现需要参考架构手册。
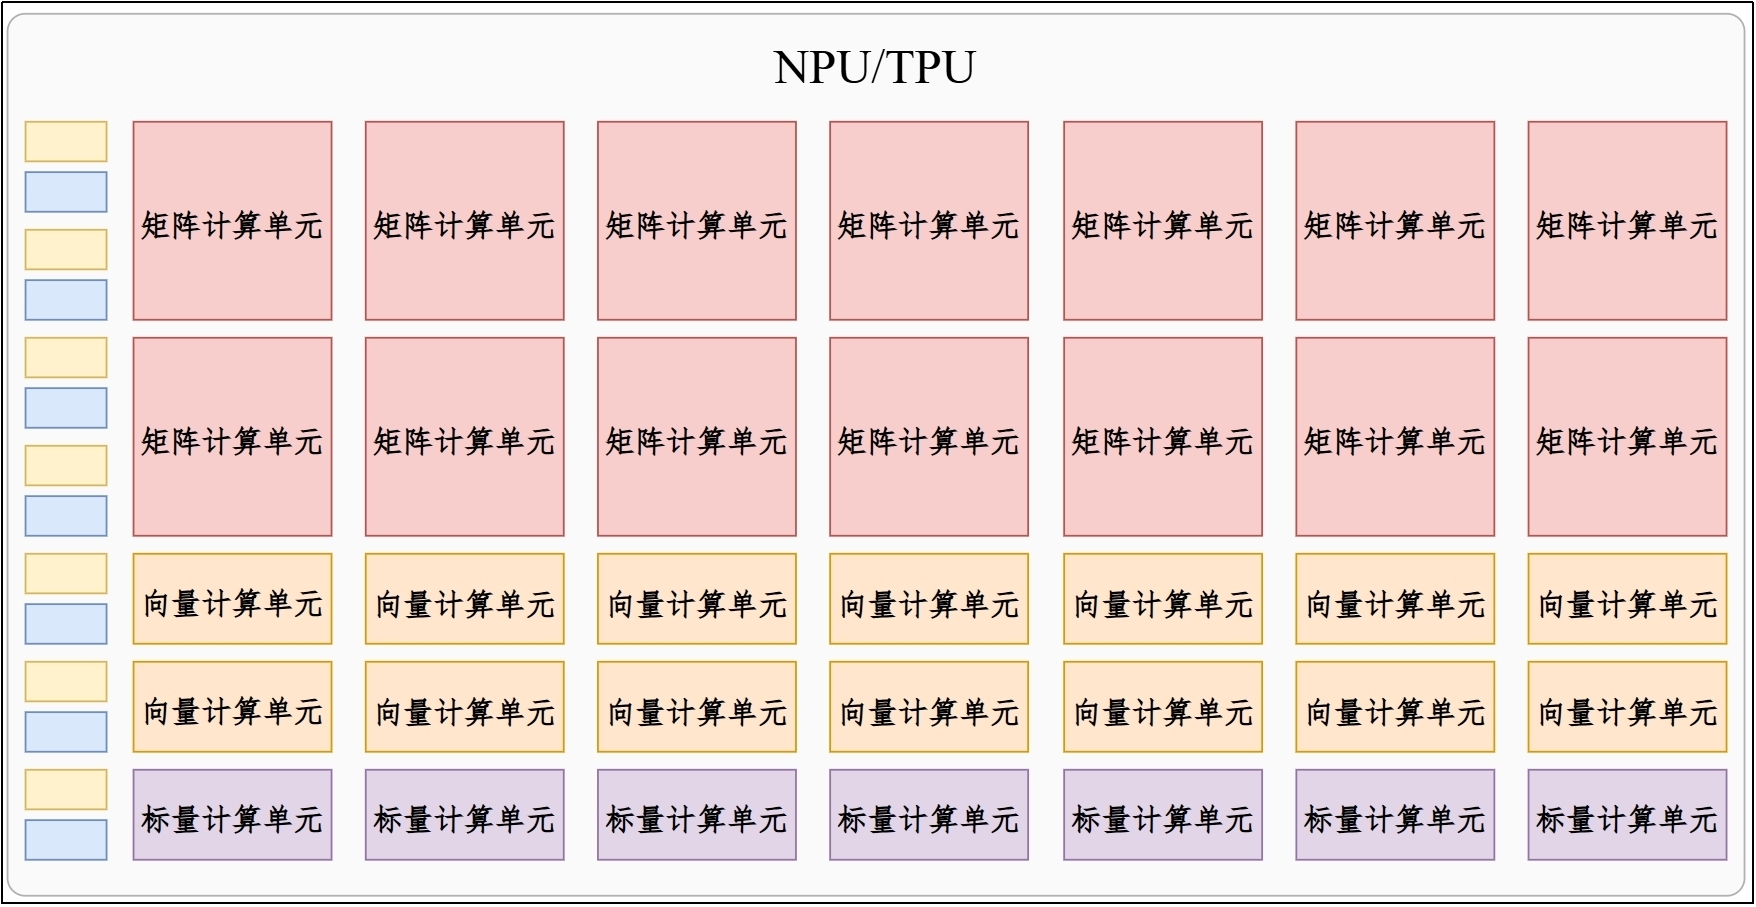
(5)TPU
TPU(Tensor Processing Unit,张量处理器)是谷歌为神经网络机器学习专门开发的专用芯片,适用于谷歌自家的TensorFlow框架。2015年开始内部使用,2018年向第三方开放。
发布后处于第一梯队的Gemini-3系列模型就是在谷歌的TPU上训练的。
说明:本质上TPU也属于NPU的一种。
2)内存和显存
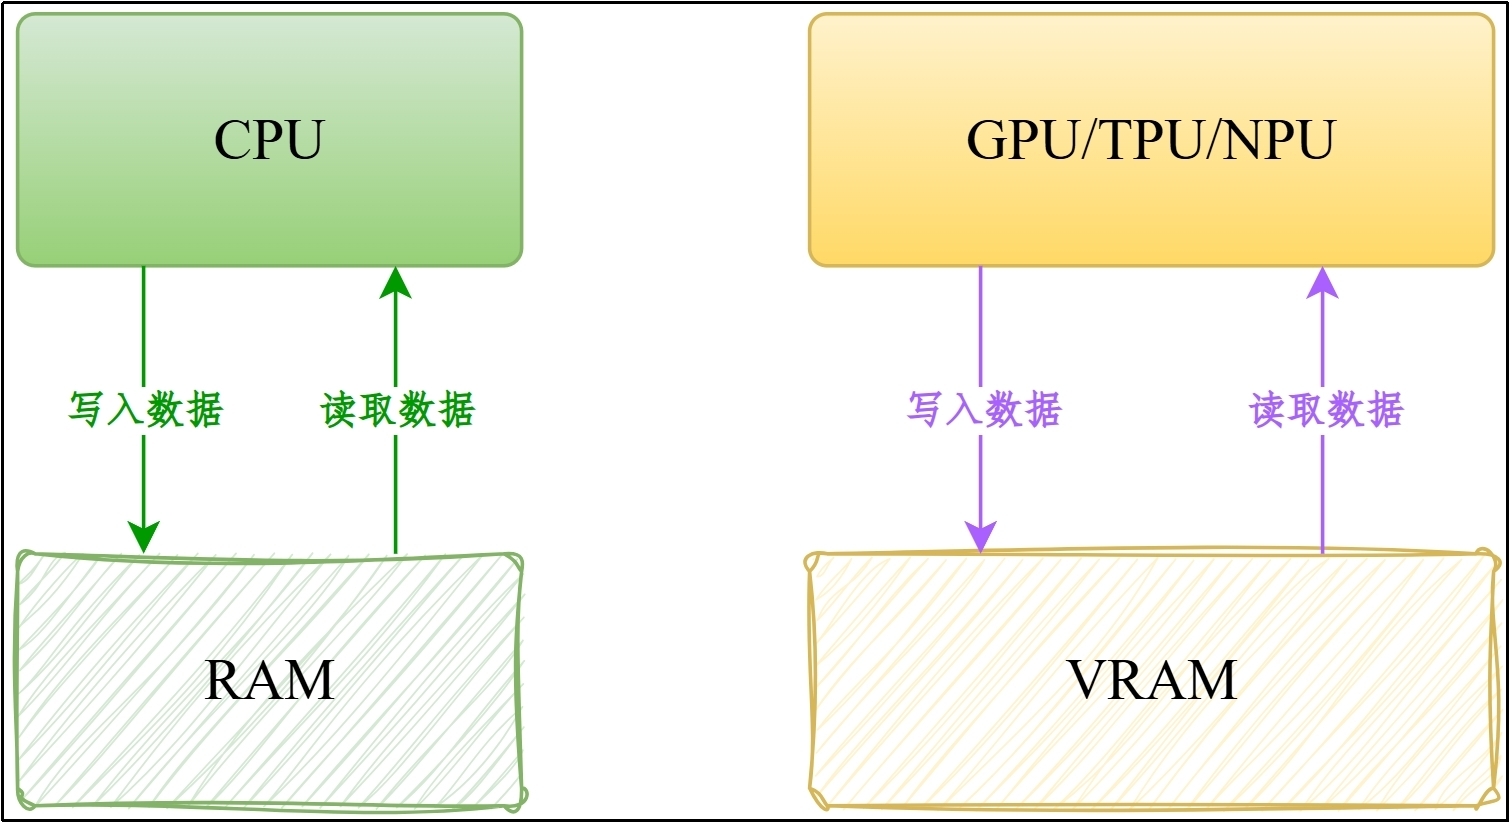
(1)内存(RAM):计算机临时工作空间,存放CPU运行所需的数据。
(2)显存(VRAM):显卡专用内存,专门存储GPU运行所需的数据。显存的常见类型有GDDR或HBM。
游戏显卡通常采用GDDR
高端计算卡(用于神经网络计算)通常采用HBM。
3)GPU主要厂家
GPU算力市场,英伟达一家独大。
4)英伟达显卡架构迭代和主要产品型号
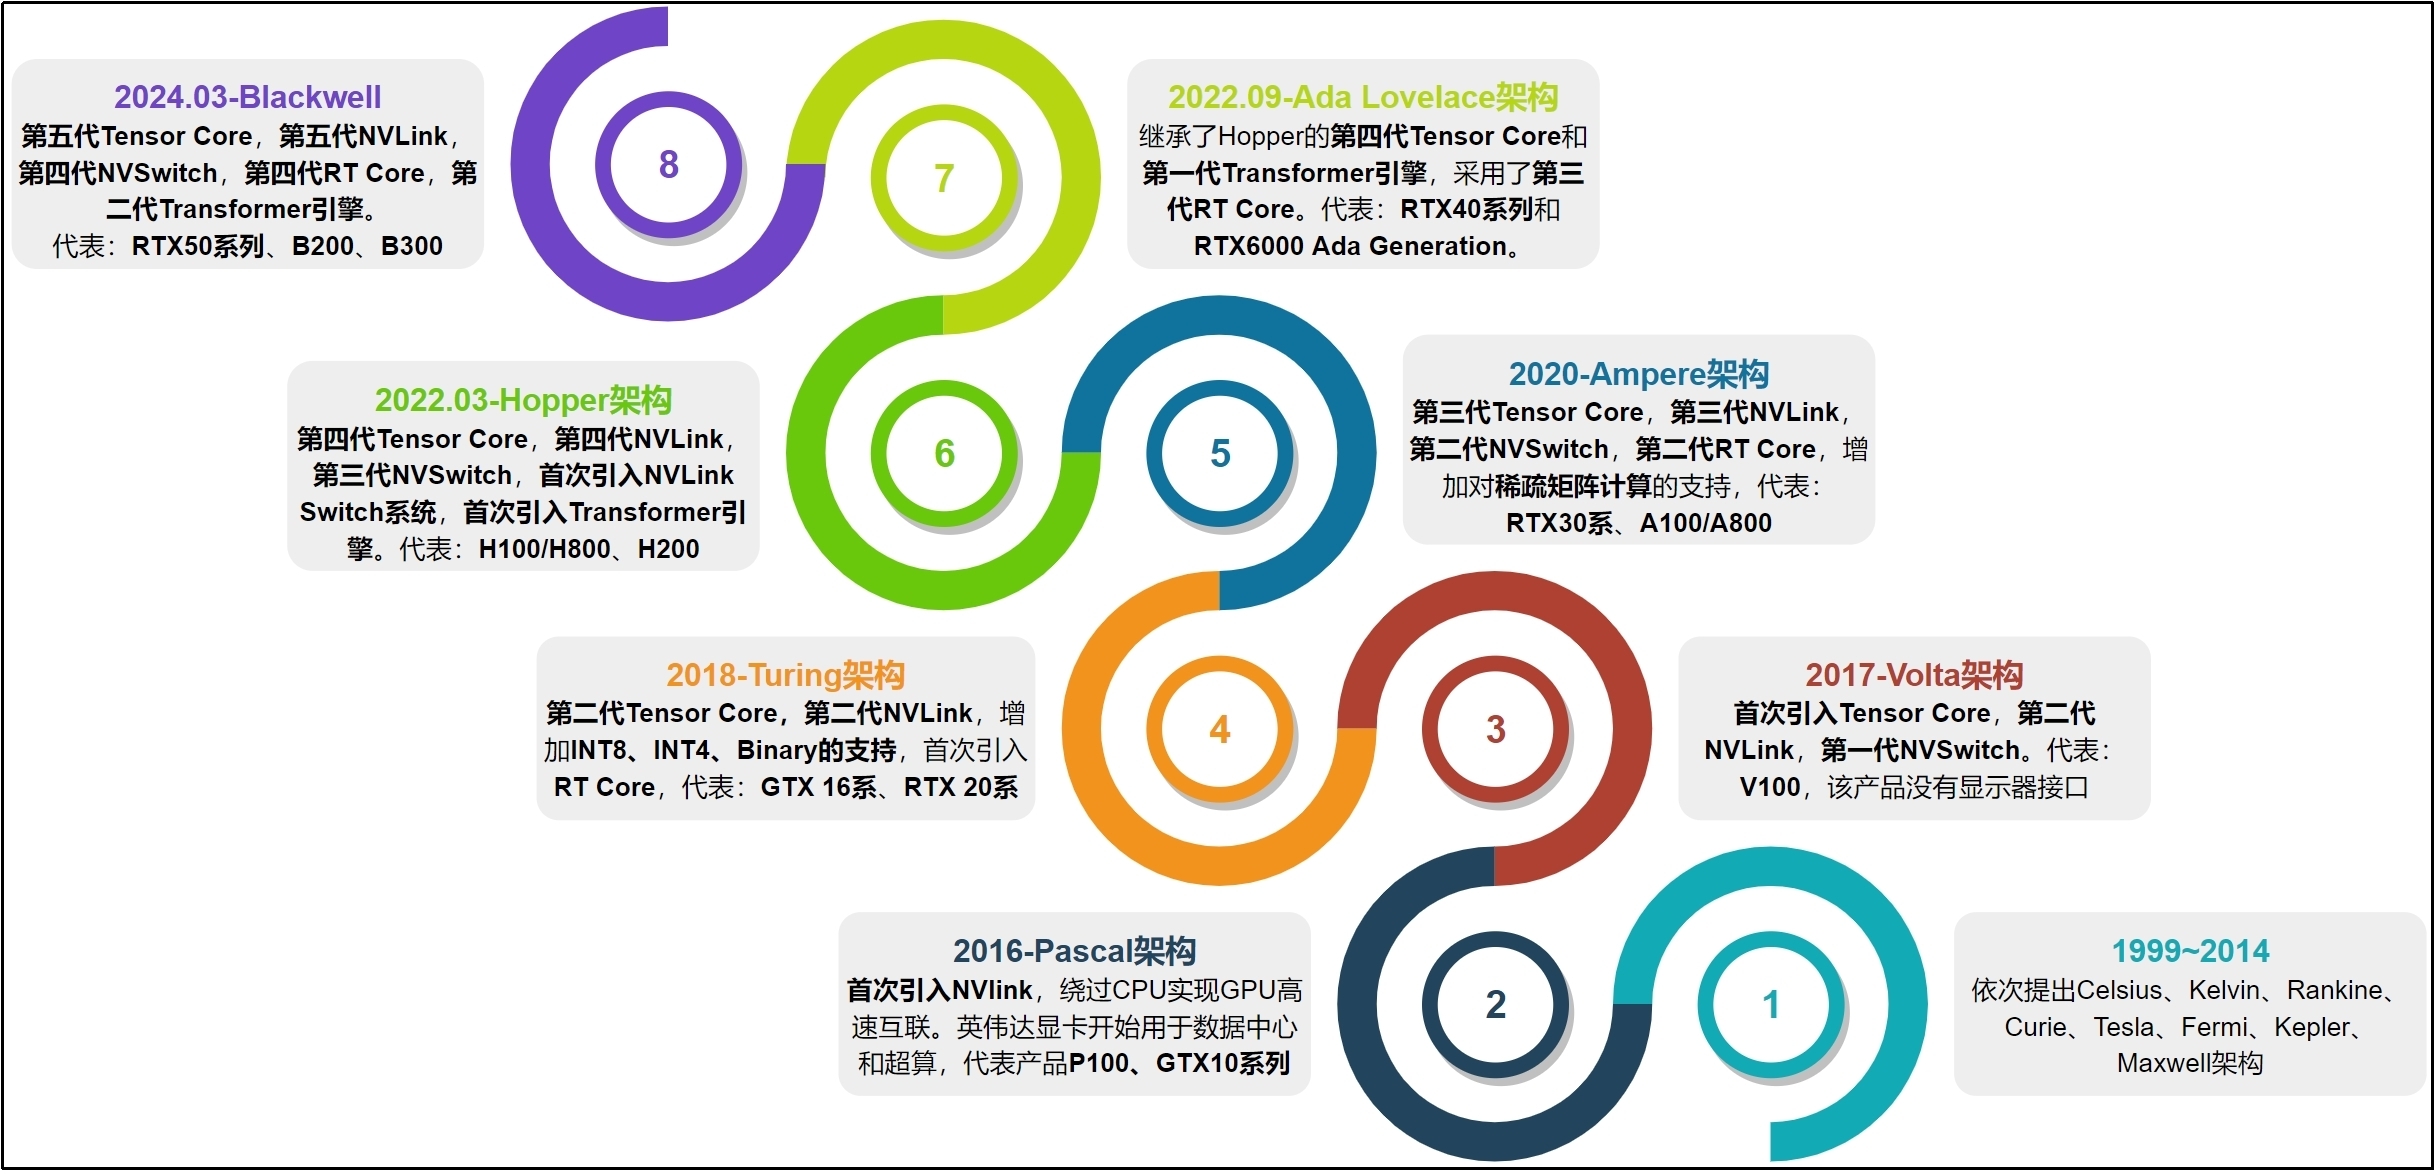
当前,大语言模型的训练与微调主要依赖于 NVIDIA 的 GPU,因其具备成熟的 CUDA 生态和高效的计算库。以下是一些常用于 LLM 微调的 GPU 型号:
型号 架构 发布时间 H100(80GB HBM3) Hopper 2022 年 3 月 H800 Hopper 2023 年 3 月 A100 Ampere 2020 年 5 月 A800 Ampere 2022 年 11 月 V100 Volta 2017 年 5 月 RTX 4090 Ada Lovelace 2022 年 10 月 RTX 3090 Ampere 2020 年 9 月
3.2.3 算力为什么不够用?
在大模型训练和推理场景中,算力长期处于“供不应求”状态。
1)训练阶段的硬件瓶颈
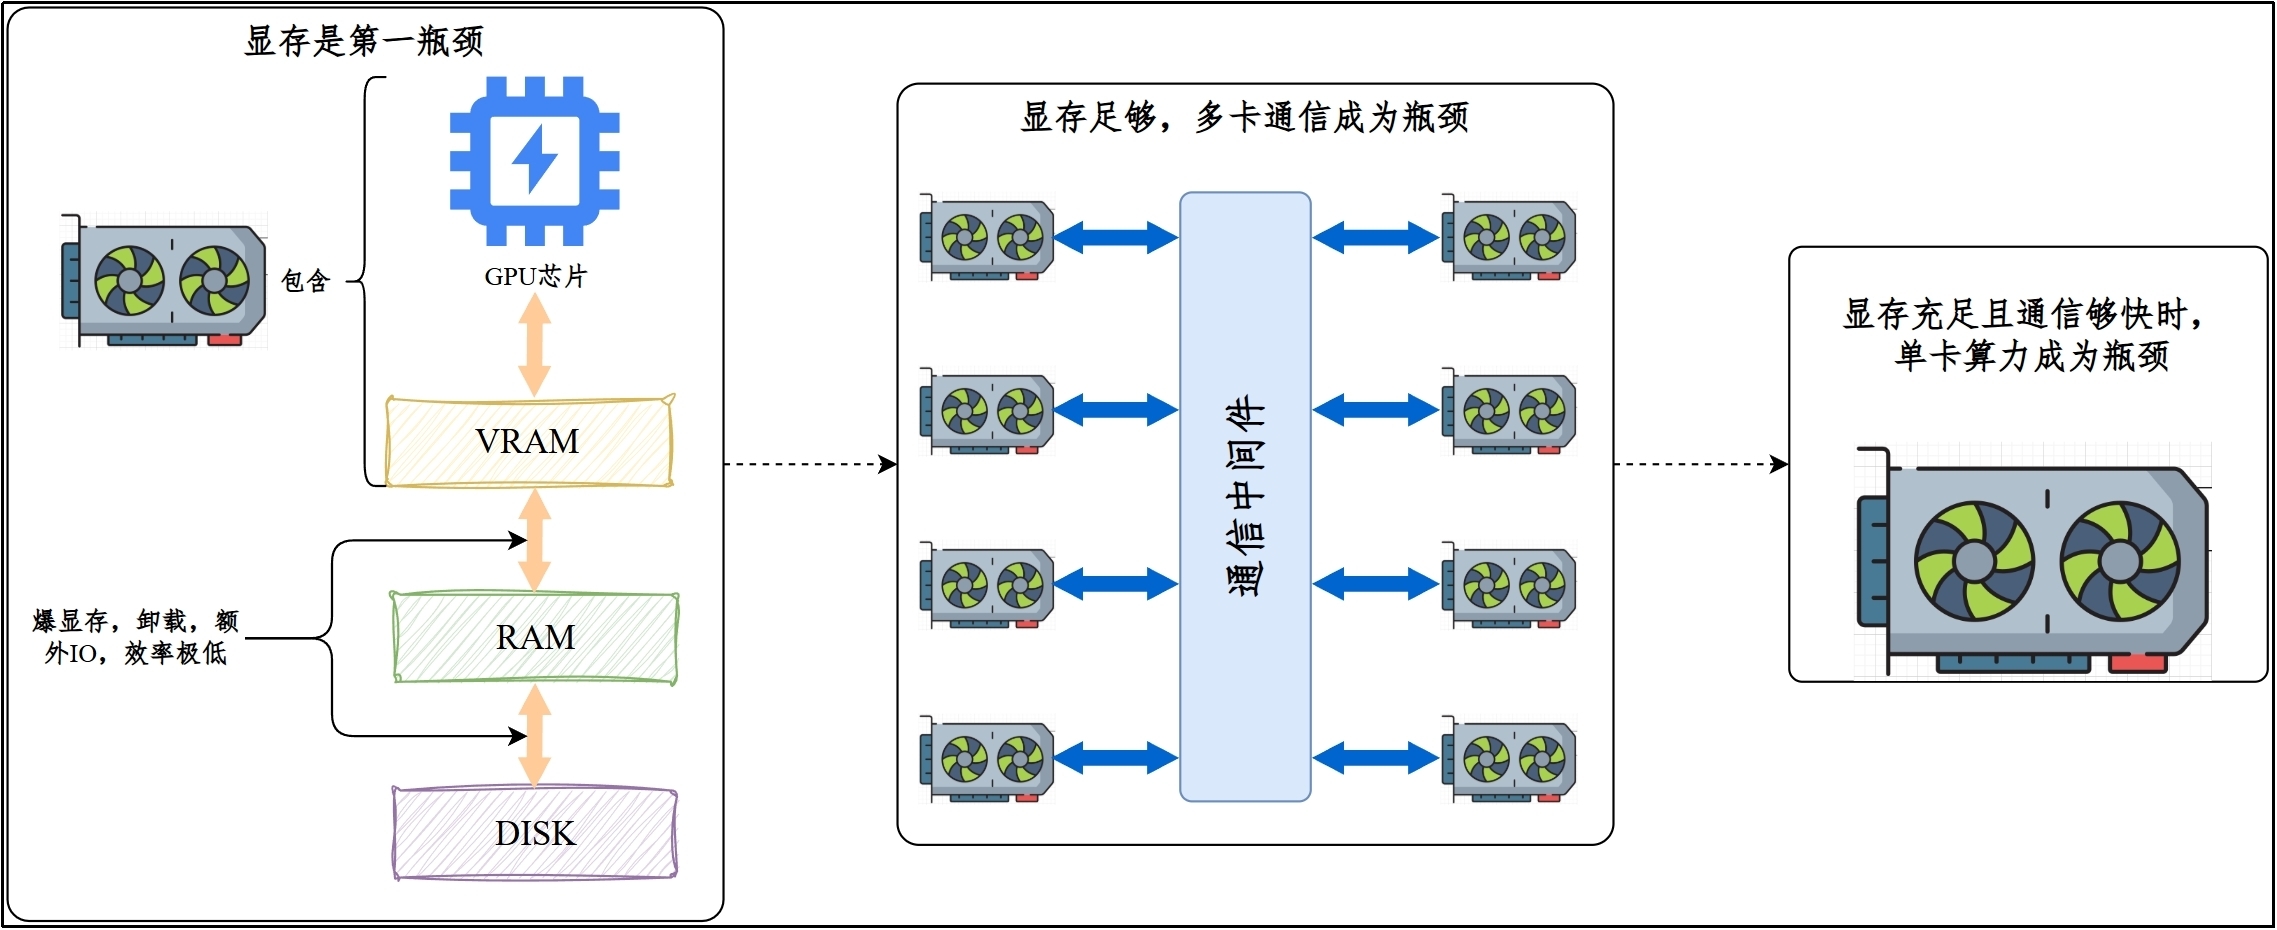
情况1:显存容量
在训练过程中,显存不仅需要存储模型参数,还需保存:梯度、优化器状态、中间激活值,显存消耗通常是模型参数本身的数倍。
爆显存(显存不足)时,部分数据会被卸载到内存甚至硬盘,此时I/O(数据在不同存储介质间的传递)将会成为瓶颈,训练效率会非常低。
情况2:多卡通信开销
顶尖大模型的规模非常大,单卡无法容纳完整模型,必须通过张量并行或流水线并行切分模型,为提升效率还会引入数据并行。此时,多卡通信将会成为新的瓶颈。
情况3:算力
算力是指显卡在单位时间内可以完成的运算次数。
模型越大,训练就越“吃算力”。目前顶尖模型的参数量在千亿甚至万亿级,即使在高性能GPU集群上,也需要数周甚至数月才能完成。算力不足,训练时间将会进一步延长。
在显存充足且通信够快的情况下,算力将会成为瓶颈。
2)推理阶段的硬件瓶颈
与训练相比,推理阶段面临的瓶颈表现出不同特点。
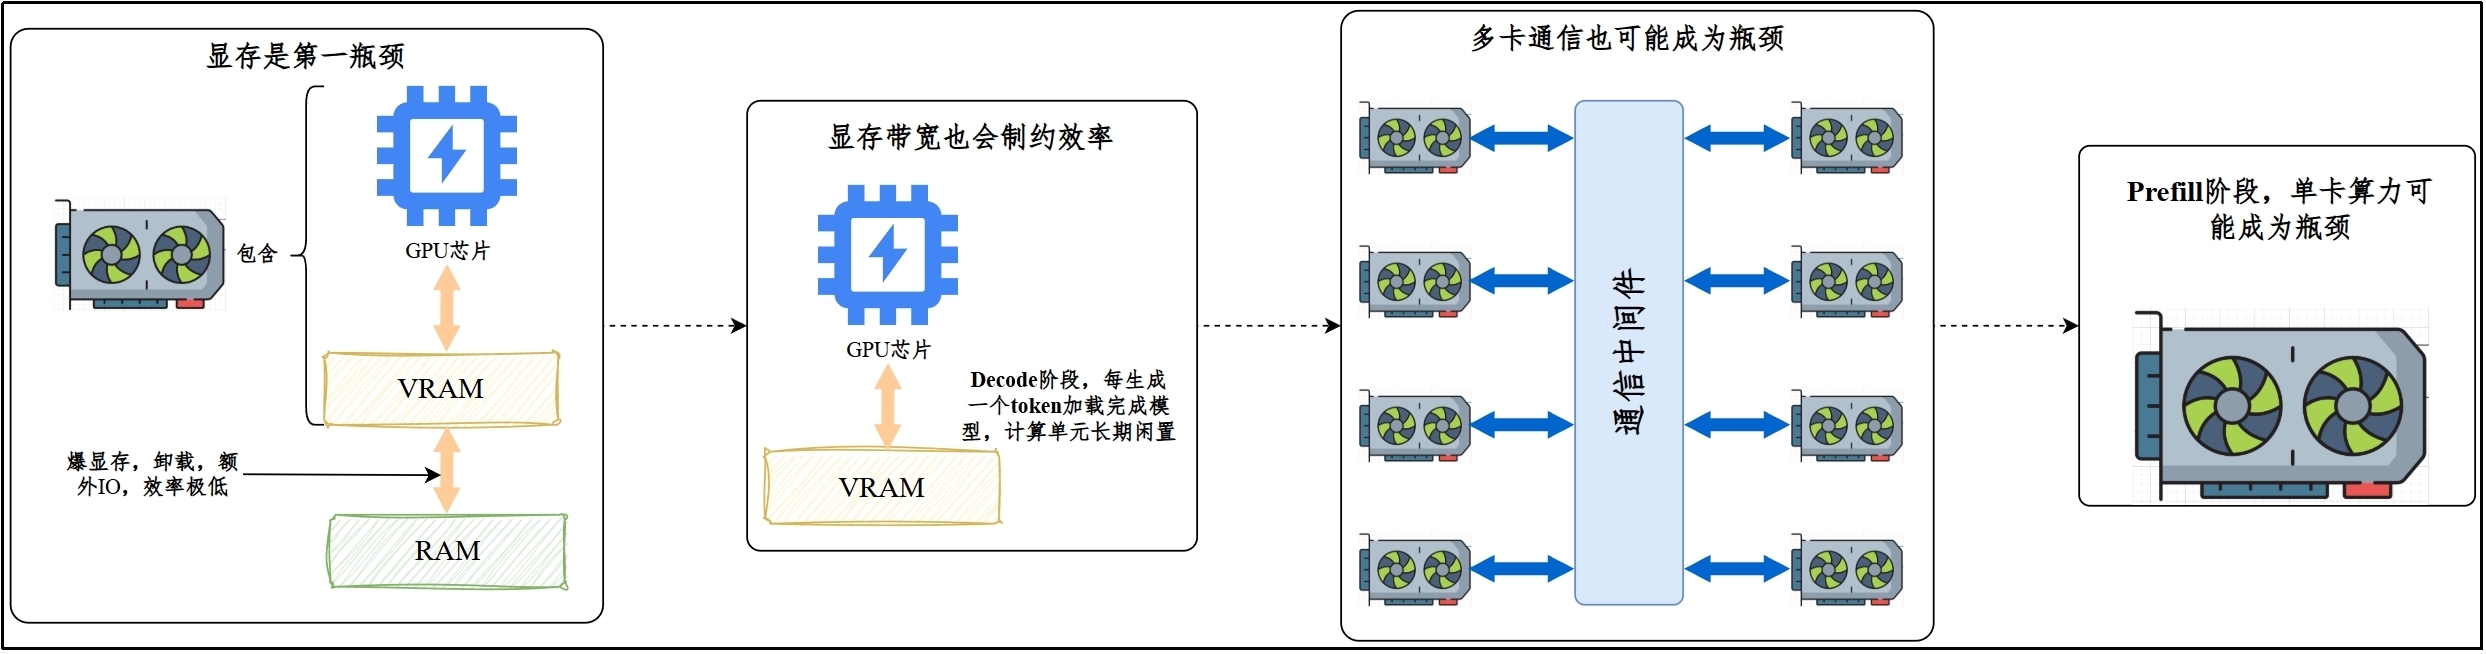
情况1:显存容量
推理阶段不需要梯度和优化器状态,即便如此,超大模型的参数本身仍然占据大量显存。此外,为了提升效率,推理阶段通常需要保存KV Cache,进一步增加显存开销。
同样,爆显存可以卸载至RAM,但会导致IO成为瓶颈,效率大幅降低。
情况2:显存带宽
训练阶段通常加载整个序列,然后进行大量并行计算。
而推理的Decode阶段是逐token生成,每生成一个token需要从显存加载整个模型和所有的KV Cache,计算单元大部分时间都在等待,此时显存带宽会成为瓶颈。
情况3:多卡通信
同样,单卡显存不足时(不考虑量化)需要用多卡集群,多卡通信效率会影响推理效率。
情况4:算力
推理的Prefill阶段计算量很大,此时算力可能会成为瓶颈。
本文由傻鸟发布,不代表傻鸟立场,转载联系作者并注明出处:https://shaniao.net/llm/695.html
